Week 2
문제 정의에서 프로젝트 구성까지: PCS로 시작하는 데이터사이언스
“식당에서 덜 기다리려면 어떻게 해야 할까?”
이 질문을 방문자가 하는 경우와 식당 운영자가 하는 경우를 생각해 보자. 각자는 무엇을 결정하려는가? 그 결정을 돕기 위해 무엇을 알아야 할까?
방문자는 “몇 시에 가야 덜 기다릴까?”를 묻고 방문 시간을 고르려 할 수 있다. 식당 운영자는 “피크 시간 좌석 안내 인력을 늘리면 대기가 줄어들까?”를 묻고 인력 배치를 바꾸려 할 수 있다. 같은 대기 시간을 이야기해도 앞의 질문에는 시간대별 대기를 알거나 예측하는 일이, 뒤의 질문에는 운영 변경의 효과를 확인하는 일이 필요하다.
이번 주에는 이처럼 막연한 바람을 누군가의 구체적인 판단을 돕는 질문으로 바꾸고, 그 질문에 필요한 관측과 검증 방법을 정한다. 식당 사례를 따라 PCS(predictability, computability, stability)로 분석의 근거를 점검한 뒤, 팀을 꾸려 관심 있는 주제와 프로젝트의 대략적인 진행 방향을 이야기한다.
지정 읽기: Yu & Barter, Veridical Data Science의 Preface, Chapter 1: An Introduction to Veridical Data Science, Chapter 2: The Data Science Life Cycle, Chapter 3: Setting Up Your Data Science Project.
교재가 말하는 veridical data science는 데이터와 모델링을 현실에 비추어 검토하고, 결과를 신뢰할 근거를 쌓는 접근이다. 현실·데이터·모델링 연결, 데이터사이언스 생애주기, 실행·기록·재현성에 대해 공부한다.
이 노트의 식당 사례는 설명을 위해 만든 예시이며, 실제 식당을 조사한 결과가 아니다. GitHub·AI 도구를 활용한 협업 방식과 팀 활동은 이 과목의 프로젝트를 위한 적용 예시다.
1. 현실의 불편을 측정 가능한 질문으로
문제 정의(problem framing)는 관심 주제를 관측·분석·검증할 수 있는 질문으로 구체화하는 일이다. 여기서는 방문자가 덜 기다릴 방문 시간을 고르는 상황을 생각해 보자. 방문 전에 정보를 알려 줄 수 있어야 하고, 대기 시간의 정의도 명확해야 한다. 줄 서는 시간만 이야기할 것인지, 입장한 뒤 음식이 나올 때까지도 포함할 것인지 정해야 한다.
어느 정도 구체화를 하고 난 뒤, 사전 문헌 조사로 문제 정의를 강화한다. 1주차에서 강조했듯이, 선행연구 조사(literature review)는 문제 정의의 일부다. 질문을 확정하기 전에 관련 연구를 읽고, 이미 밝혀진 내용과 아직 확인할 내용을 구분한다. 조사하면서 질문을 바꾸고, 데이터를 확인한 뒤 필요한 문헌을 다시 찾을 수도 있다.
식당 사례라면 대기 시간 예측과 혼잡 안내에 관한 연구에서 다음을 확인한다.
| 문헌에서 확인할 내용 |
|---|
| 대기 시간을 어떻게 정의하고 어떤 데이터를 사용했는가? |
| 어떤 방법과 비교하고 어떤 조건에서 평가했는가? |
| 무엇을 밝혔고 어떤 한계가 남았는가? |
각 문헌의 출처와 함께 데이터·방법·결과·한계·우리 질문과의 관계를 짧게 기록한다. 같은 주제를 다룬 연구가 있어도 다른 환경에서 결과가 유지되는지 검증할 가치는 있을 수 있다.
예를 들어 기존 연구가 직장 상권의 식당만 다뤘다면, 이용 패턴이 다를 수 있는 학교·주거 상권에서도 같은 방법이 잘 작동하는지 확인할 수 있다. 기존 방법의 성능이 떨어지는 조건을 찾고, 그 환경의 특성을 반영한 모델링이 예측을 개선하는지 검토하는 것도 프로젝트의 문제 정의가 될 수 있다.
1.1 현실·데이터·모델을 연결하기
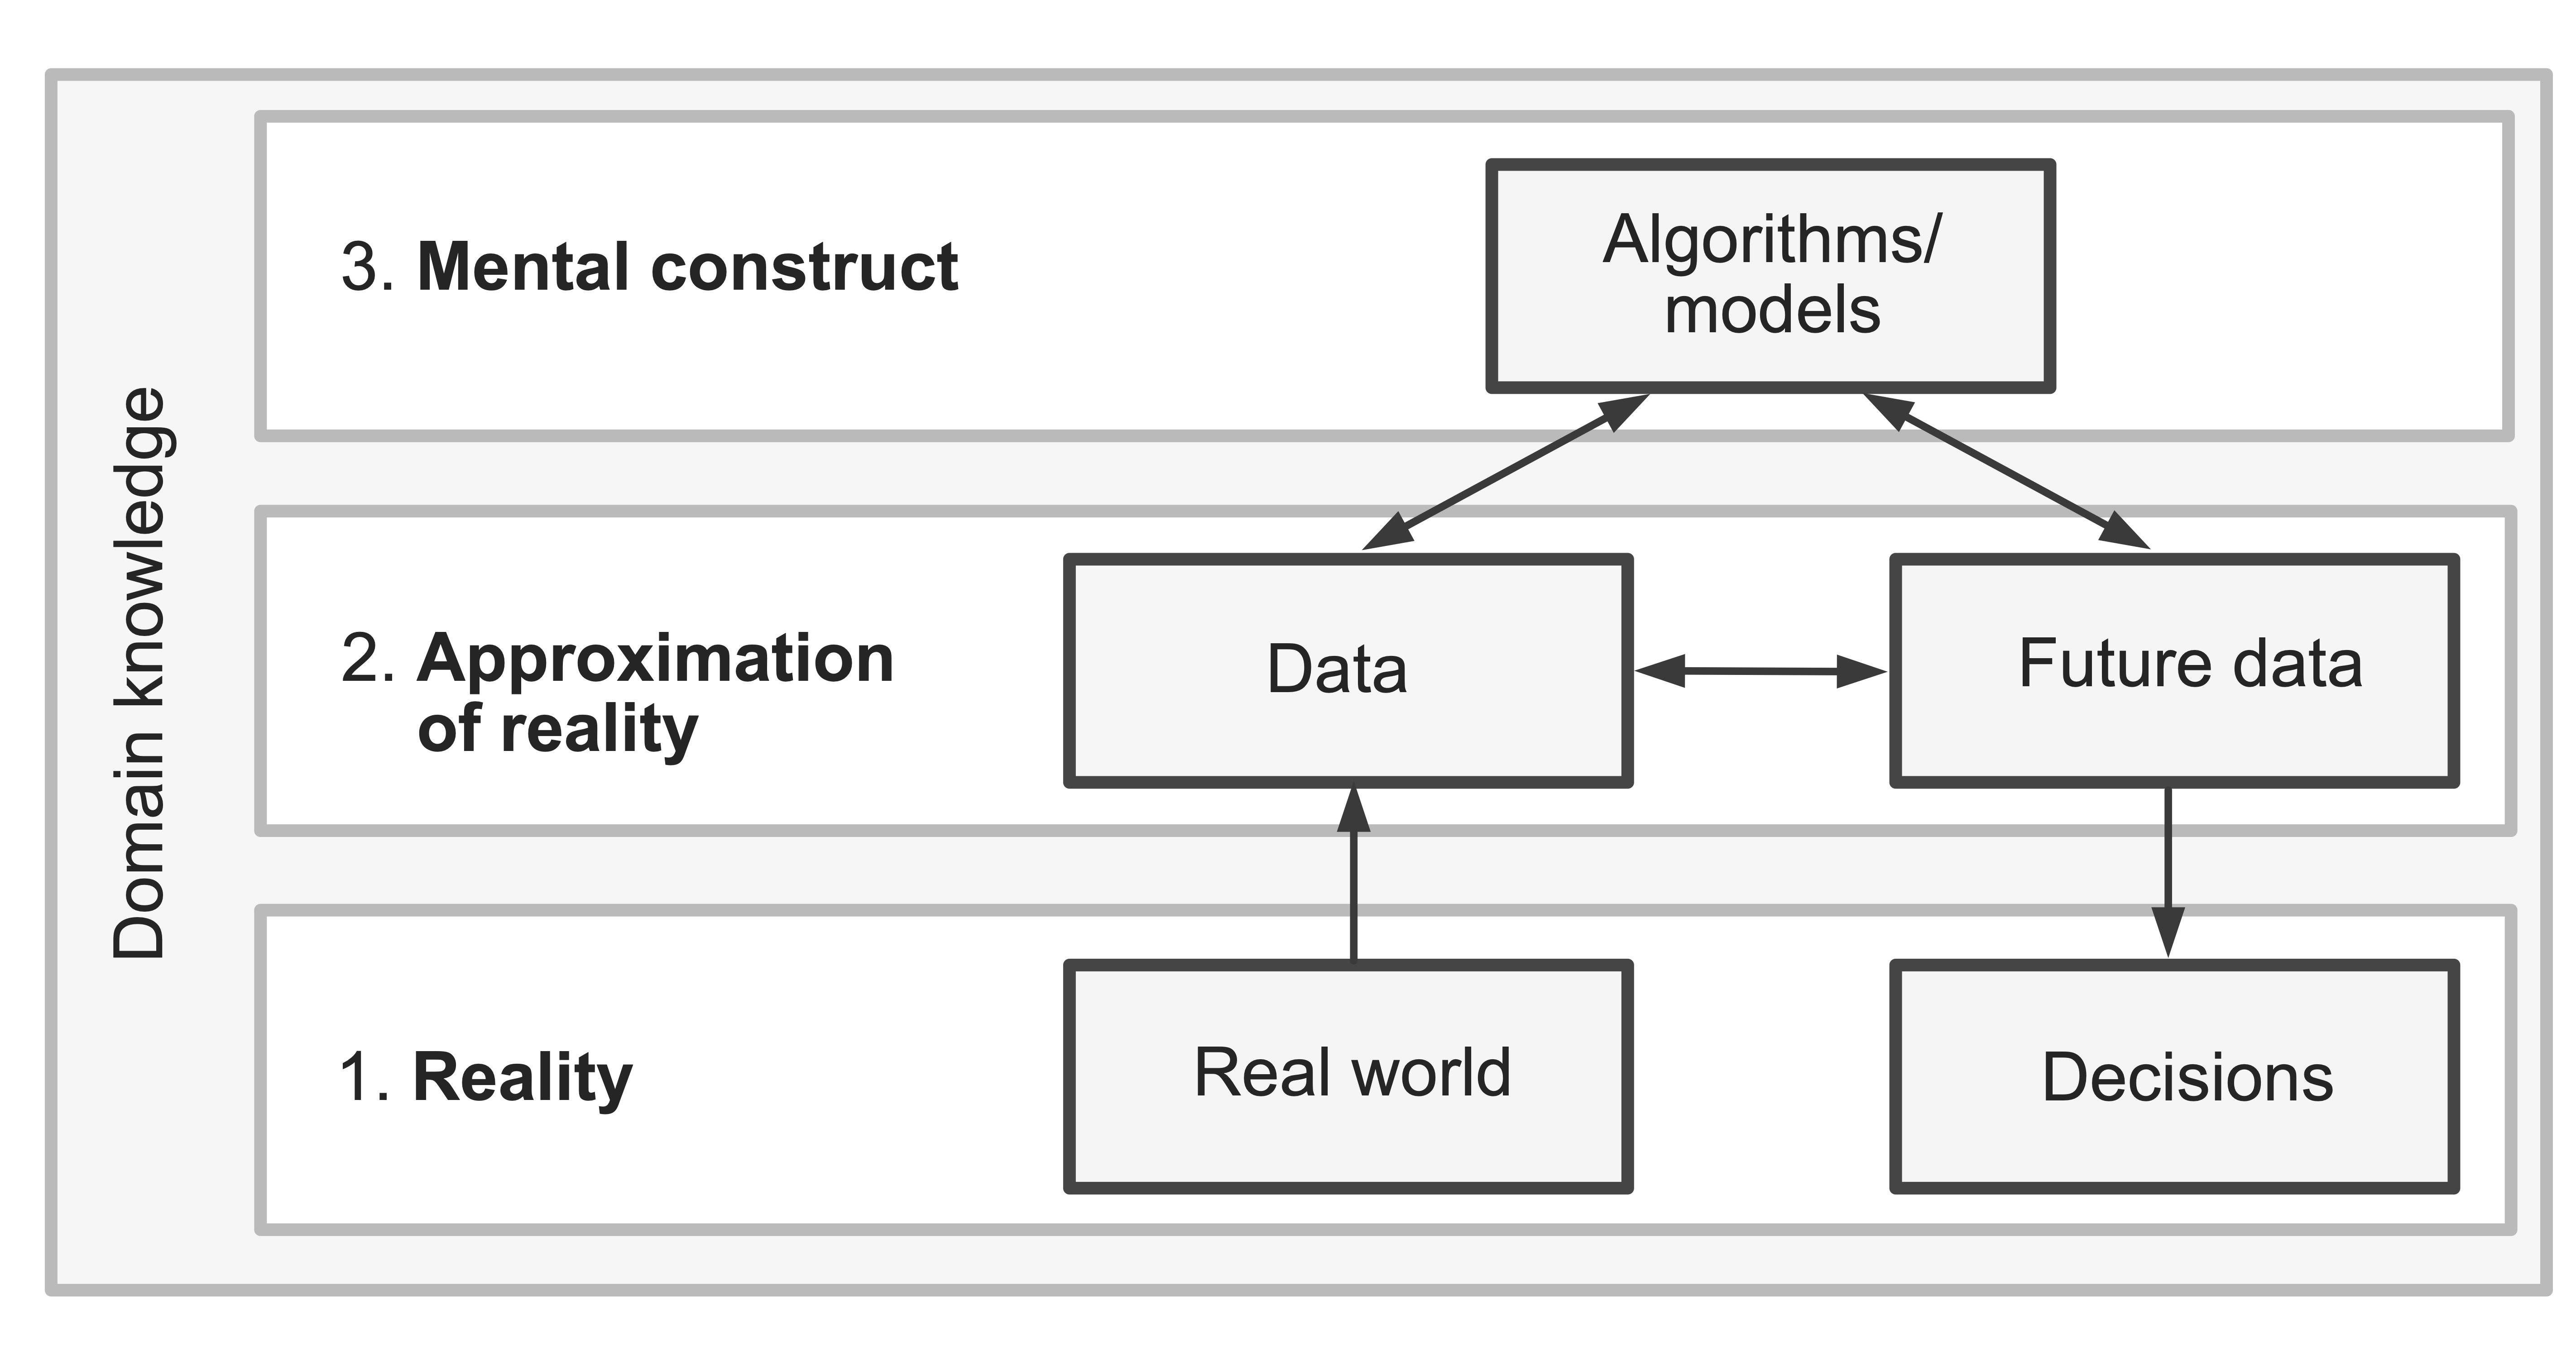
데이터와 모델이 현실을 얼마나 적절히 반영하는지 묻는다.1 아래 도식은 현실, 현실의 일부를 관측한 데이터, 모델·알고리즘을 이용한 분석을 구분한다. 현재 자료에서 얻은 결과가 미래 자료에서도 성립하는지, 실제 판단에 도움이 되는지까지 연결해서 보아야 한다.
1.2 예시 사례
“대기 시간”을 계산하려면 시작과 끝을 정해야 한다. 개념을 구체적인 측정 규칙으로 정하는 것을 조작화(operationalization)라고 한다. 우리는 일행이 대기를 등록한 시각과 실제 입장한 시각을 남기는 시스템을 가정한다. 대기 시간은 등록부터 입장까지이며, 입장 뒤 주문·조리 시간은 포함하지 않는다. 실제 프로젝트에서는 제공되는 변수와 기록 방식을 먼저 확인해야 한다.
다음은 식당 A의 어느 평일 점심에 등록한 일행들의 가상 데이터이다. 이 예시에서는 끝까지 기다린 일행이 등록 순서대로 입장한다고 가정한다.
| 등록 ID | 등록 시각 | 입장 시각 | 설명 |
|---|---|---|---|
| A | 11:50 | 12:00 | 입장까지 10분 |
| B | 11:52 | - | 중도 이탈 |
| C | 11:55 | 12:15 | 입장까지 20분 |
| D | 11:58 | 12:20 | 입장까지 22분 |
| E | 12:00 | 12:25 | 입장까지 25분 |
| F | 12:05 | - | 중도 이탈 |
| G | 12:10 | 12:40 | 입장까지 30분 |
| H | 12:20 | - | 중도 이탈 |
| I | 12:25 | 13:00 | 입장까지 35분 |
| J | 12:30 | 13:02 | 입장까지 32분 |
| K | 12:40 | 13:05 | 입장까지 25분 |
| L | 12:50 | 13:08 | 입장까지 18분 |
원하는 데이터가 아니라고 해서 함부로 지우지 않는다. B·F·H의 행을 없애면 이탈했다는 사실도 사라진다. 입장 대기 시간 계산에 사용하지 않더라도 이탈 상태는 보존한다. 특히 긴 대기를 예상한 일행이 더 많이 포기했다면, 입장한 일행의 대기만으로 모든 등록자의 상황을 설명하기 어렵다.
위 기록에서 직접 계산할 수 있는 것은 실제로 입장한 일행의 대기 시간이다. 방문자가 시간대를 고르는 데 참고할 수 있도록, 이를 등록 시각의 30분 구간별로 묶어 보자. 입장 시각이 기준은 아니다. D는 12:20에 입장했지만 11:58에 등록했으므로 11:30–12:00 구간에 들어간다. 구간 시작은 포함하고 끝은 제외하므로 E는 다음 구간에 들어간다.
| 등록 시각 구간 | 등록한 일행 | 입장자의 대기 시간 | 평균 | 입장 / 이탈 건수 |
|---|---|---|---|---|
| 11:30–12:00 | A–D | 10, 20, 22분 | 약 17.3분 | 3 / 1 |
| 12:00–12:30 | E–I | 25, 30, 35분 | 30분 | 3 / 2 |
| 12:30–13:00 | J–L | 32, 25, 18분 | 25분 | 3 / 0 |
평균은 입장한 일행들의 대기 시간 합을 입장 건수로 나눈 값이다. 이탈한 일행을 0분으로 넣거나 전체 등록 건수로 나누지 않는다.
이 표는 관측한 하루를 요약한 것이다. 여러 날의 기록을 확보해 앞으로의 시간대별 대기를 예측하려 한다면, 타겟은 예측할 구간에 등록한 일행 중 최종 입장한 일행의 평균 대기 시간으로 정할 수 있다. 입력으로는 예측 시점까지 확인된 과거 기록의 입장 건수, 이탈 건수, 입장자의 대기 시간 등을 활용한다. 이렇게 과거 기록에서 만든 입력과 예측할 타겟 사이의 관계를 학습해, 새로운 구간의 평균 대기 시간을 예측하는 모델을 만드는 것이 예측 모델링(predictive modeling)이다. 학습할 때는 여러 날의 기록에서 각 예측 시점까지 알 수 있었던 입력과, 그 이후 확인된 해당 구간의 실제 평균 대기 시간을 짝지어 사용한다. 실제로 예측할 때는 아직 타겟을 모르므로 입력만 모델에 넣어 예측값을 얻는다.
1.3 기대에 맞는 결과도 의심하기
위 자료에서 12:00–12:30에 등록한 입장자의 평균 대기는 30분이고, 다음 구간은 25분이다. “점심 피크가 지나면 덜 기다릴 것”이라는 기대와 맞는 결과다. 그렇다면 시간이 지나 손님이 줄었기 때문에 대기가 짧아졌다고 설명해도 될까?
우리가 가진 것은 등록·입장 시각과 이탈 여부뿐이다. 그 시간대에 비가 내려 방문 패턴이 달라졌거나, 식당이 좌석 운영이나 직원 배치를 바꿨을 수도 있다. 주변 회사의 점심시간이나 근무 방식이 바뀌었을 가능성도 있다. 이들은 확인된 원인이 아니라, 현재 자료에 없어 영향을 확인하지 못한 요인의 예다. 기대한 방향의 결과가 나왔다는 사실만으로 우리가 생각한 원인이 맞았다고 할 수는 없다. 기대에 맞는 결과도 이런 다른 가능성을 함께 검토해야 한다.1
현실의 모든 요인이 데이터에 담겨 있지는 않다. 이런 상황은 실제 분석에서 흔히 마주친다. 중요한 것은 관측한 차이와 그 차이에 붙인 설명을 구분하는 것이다. 이 예시에서는 다음과 같이 말할 수 있다.
이날 기록에서는 12:30–13:00에 등록한 일행 중 최종 입장한 일행의 평균 대기가 앞 구간보다 5분 짧았다. 다만 날씨나 운영 변경 정보가 없어, 이 차이가 생긴 이유는 확인하지 못했다. 다른 날에도 같은 시간대의 대기가 짧은지는 추가 기록으로 검증해야 한다.
원인을 더 알아야 한다면 날씨 자료를 연결하거나 운영 담당자에게 변경 사항을 확인한다. 추가 정보를 얻기 어렵다면 확인하지 못한 요인을 한계로 남기고, 현재 기록으로 뒷받침할 수 있는 범위에서 결론을 쓴다. 추가 정보를 확보하더라도 원인을 밝히려면 비교 조건을 검토해야 한다.
자료가 불완전해도 관측한 패턴을 정리하고, 추가로 확인할 질문을 만드는 일은 의미가 있다. 무엇을 확인했고, 무엇은 아직 설명하지 못하며, 어디까지 적용할 수 있는지 말할 수 있어야 한다. 다음 절에서는 이런 결과와 예측을 믿을 근거를 어떻게 점검할지 살펴본다.
2. 답을 믿을 근거를 설계하기: PCS
예측 모델을 하나 개발했다고 하자. 앞으로의 구간별 평균 대기 시간을 얼마나 잘 맞힐지, 다른 타당한 처리 방법을 썼어도 비슷한 결과가 나올지 확인해야 한다. PCS에서는 predictability로 현실과 대조하고, stability로 타당한 변화에 따른 결과의 변동을 살핀다. Computability는 이런 분석과 검증을 수행할 수 있게 하는 계산이다.1
노트
§2.1–2.3은 이번 학기 프로젝트 전반에서 반복해서 적용할 핵심 원칙이다. 문제 정의, 데이터 처리, 분석, 결과 해석에서 각각 어떤 근거를 확인했는지 설명할 수 있어야 한다.
2.1 Predictability: 현실과의 대조
Predictability는 분석 결과가 실제로 적용하려는 새로운 상황에서도 성립하는지 현실과 대조하는 원칙이다. 관련된 미래·외부 자료에서 결과를 확인하는 것이 강한 근거가 된다. 이 원칙은 예측 모델뿐 아니라 탐색(e.g., EDA)에서 발견한 패턴에도 적용된다.1
식당 대기 시간에 대한 예측 모델링은 앞으로의 등록 구간에서도 입장자 대기 평균을 맞힐 수 있는지 확인해야 한다. 가상으로 12주 기록이 있고 여러 예측 방법을 비교한다면 다음과 같이 설계할 수 있다.
| 자료 | 식당 사례의 구성 | 역할 |
|---|---|---|
| Training set | 처음 8주 | 패턴 탐색, 전처리 규칙의 추정, 모델 학습 |
| Validation set | 다음 2주 | 새 자료를 대신한 평가, 후보 방법의 비교·선택 |
| Test set | 마지막 2주 | 선택을 마친 분석에 대한 추가적인 최종 평가 |
Validation의 기본 역할은 새 자료에서의 검증을 대신하는 것이다. 그 결과를 보고 방법까지 골랐다면 선택 과정에 사용된 자료이므로, 최종 성능을 별도의 test 자료에서 다시 확인한다. 항상 위와 같은 데이터 분할을 하라는 것은 아니다. 위의 분할은 같은 식당에 대한 예측으로 적절한 분할이고, 만약 다른 식당에 대한 예측을 한다면 데이터 분할 구성은 달라질 것이다.
데이터 전처리 과정에 있어서 중도 이탈한 사람에 대해 대기 시간을 0분으로 하는 처리를 할 수도 있다. 그러나, 이러한 처리가 현실과 대조했을 때 합리적인지 생각해야 한다.
평가에서는 예측값과 정답을 어떤 메트릭으로 계산할지도 정한다. 사용한 메트릭이 현실과 연관 지어 해석 시 의미를 가져야 한다. 그리고, “오차가 줄었다”와 “이용자가 시간 선택에 우리 모델을 쓸 만큼 줄었다”를 구분한다. 실용적인 개선 기준은 도메인 지식이 있는 전문가 의견으로 정하고, 아직 근거가 없으면 잠정 기준임을 적는다.
2.2 Computability: 검증을 가능하게 하는 계산
Computability는 분석과 검증을 실제 계산으로 수행할 수 있도록 하는 기반이다. 명확하고 효율적이며 확장·재현 가능한 계산을 강조한다. 계산 자원과 알고리즘의 실행 가능성이 predictability와 stability의 검사를 가능하게 한다고 설명한다.12
| 계산에서 확인할 점 | 예시에서의 구체적인 확인 |
|---|---|
| 명확성 | 데이터 집계 및 모델링을 코드와 설정(configuration)으로 확인 |
| 효율성 | 공통 계산을 재사용해 실행 시간을 줄이고, 불필요한 자료 복사를 줄여 메모리 사용을 관리 |
| 확장성 | 작은 표본에서 끝난 계산을 전체 표본에도 수행할 수 있는지 측정 |
| 재현성 | 입력·환경·설정을 기록하고 같은 계산을 다시 실행해 결과를 확인 |
실제 시간과 메모리는 작은 pilot으로 측정하고, 전체 자료에서의 실행과 반복 실험을 감당할 수 있는지 판단한다. 자원 제약 때문에 비교할 방법을 줄였다면 어떤 검사를 생략했는지도 남긴다. 계산을 끝낼 수 있다는 사실만으로 결과가 현실에 맞거나 안정적이라고 결론 내리지는 않는다.
2.3 Stability: 결과의 변동과 불확실성
Stability는 자료와 분석 과정에 타당한 변화를 주었을 때 결과가 얼마나 일관되게 유지되는지를 살피는 원칙이다. 모든 숫자가 완전히 같아야 한다는 뜻은 아니다. 어떤 변화를 허용하고 어느 정도의 차이를 중요한 것으로 볼지는 수집 과정, 도메인 지식, 결과의 사용 목적에 근거해 정한다.12
이때 비교를 위해 만드는 변화를 perturbation이라고 한다. 자료 수집, 정제·전처리의 판단, 알고리즘 선택을 주요 불확실성의 원천으로 다룬다.
| 불확실성 | 예시 |
|---|---|
| 자료 수집 | 관측한 날짜의 구성을 달리한 학습 자료 |
| 정제·전처리 | 기록 오류가 많은 날을 학습에 포함하거나 제외 |
| 알고리즘 | 질문에 맞는 서로 다른 예측 방법 |
안정성 검사는 관심 결과, 비교할 변화, 변동을 요약할 기준을 함께 정해야 한다. 예를 들어, 데이터에 누락이 많은 날짜가 포함되어 있다고 하자. 이에 대해 살펴보기 위해, 누락이 많은 날짜를 제외하고 학습한 모델과 모두 포함하여 학습한 모델의 성능을 비교한다. 다만, 결과가 좋아지는 날짜만 골라 지우는 선택을 타당한 perturbation으로 삼을 수는 없다.
그리고, 같은 코드·자료·설정으로 다시 계산하는 것은 계산 재현성(computational reproducibility)을 확인한다.
P와 S는 서로 겹치기도 한다. 미래·외부 자료에서 결과를 다시 확인하는 predictability 평가는 자료가 달라져도 결과가 유지되는지 본다는 점에서 stability의 한 경우로 볼 수 있다. 다만 여러 정제 방법을 비교한 것과 실제 미래 자료에서 검증한 것은 얻은 근거가 다르므로, 무엇을 확인했는지 구체적으로 밝혀야 한다.1
3. 데이터 사이언스 생애주기
DSLC(data science life cycle)는 질문, 데이터 준비, 분석, 평가, 전달을 연결한다. 뒤에서 발견한 문제가 앞 단계의 수정을 요구할 수 있다.3
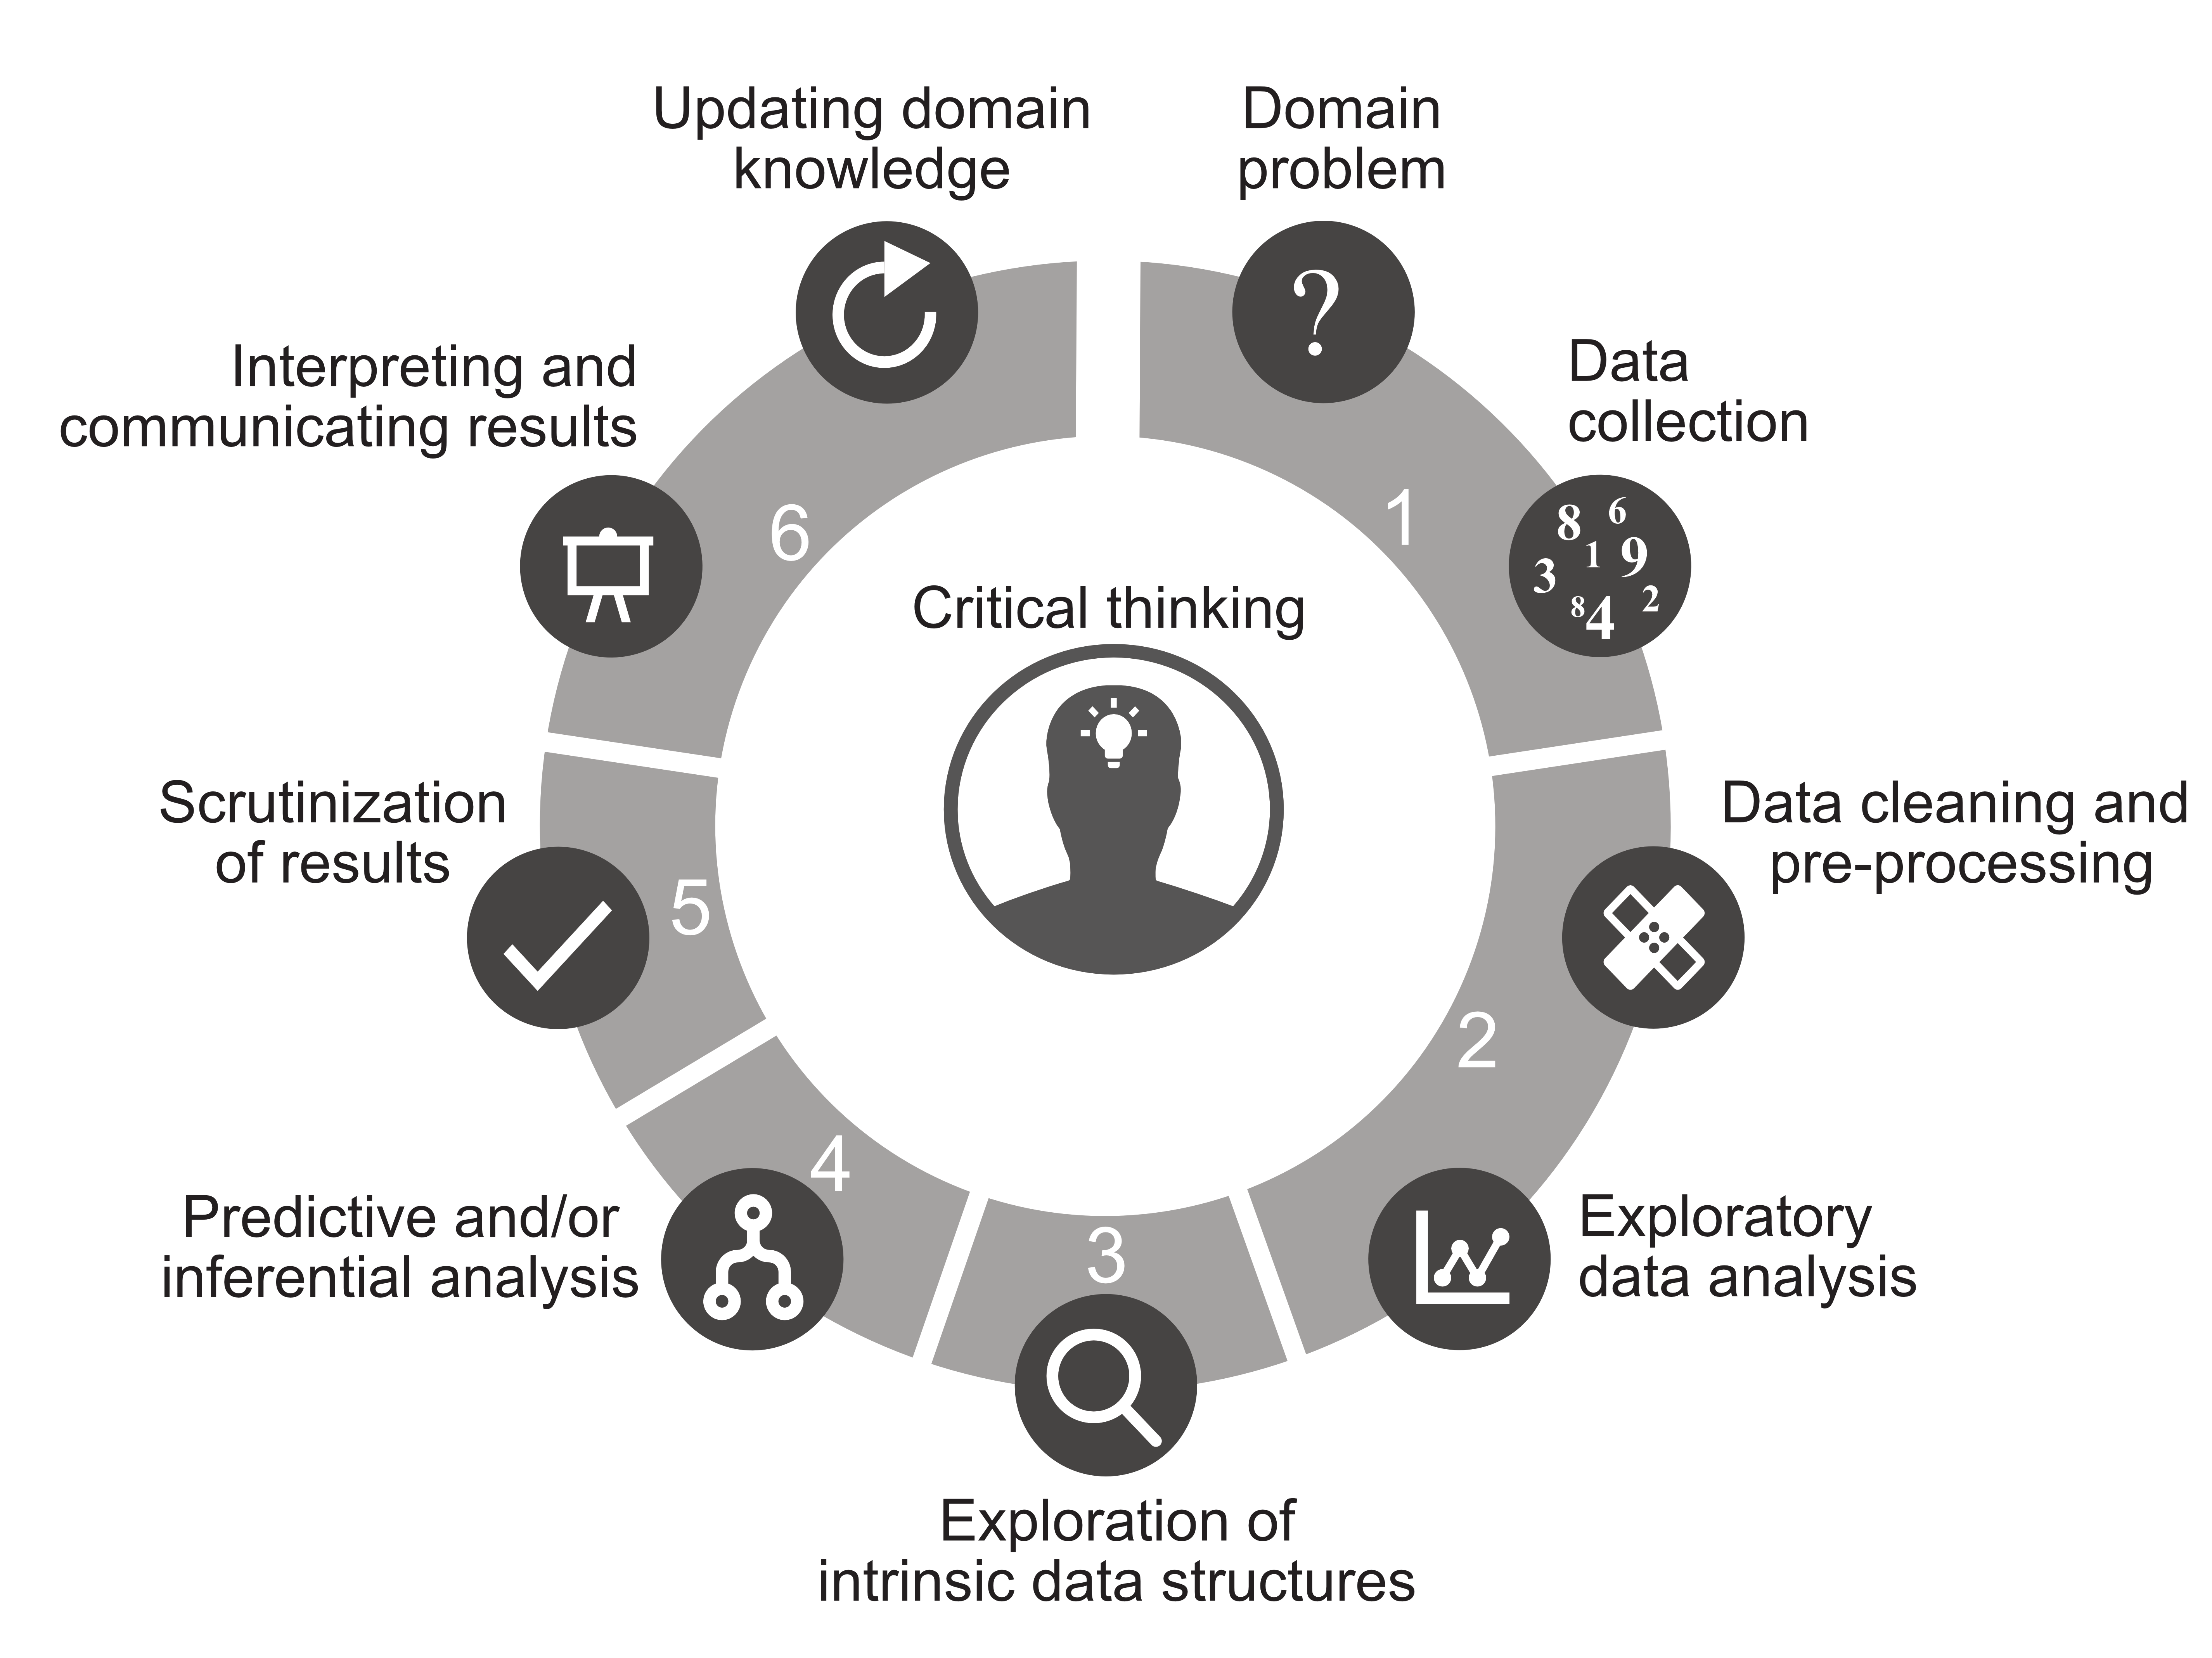
그림의 3·4단계는 질문에 따라 필요할 때 수행한다. 혼잡 시간대를 기술하는 질문이라면 요약과 시각화가 주요 분석이 될 수 있다. 평가는 5단계에만 하는 일이 아니다. 문제 정의를 위해서 대기 시간 정의를, 정제할 때는 결측 처리의 영향을 확인하는 것처럼 작업 전반에서 도메인 지식과 PCS로 판단을 점검한다.
| 단계 | 예시 |
|---|---|
| 1. 문제 정의·수집 | 대기 시간의 정의, 데이터 수집 가능성 |
| 2. 정제·전처리·EDA(exploratory data analysis) | 날짜별 입장·이탈 구분한 표, 대기 시간 분포 |
| 3. 구조 탐색(선택) | 특이 패턴을 군집으로 묶을 필요가 있는지, 묶인 결과의 의미 |
| 4. 예측·추론(선택) | 질문에 맞는 예측 모델링, 예측 시 비교할 baseline |
| 5. 평가 | 학습에 사용하지 않은 기간에서의 오차 |
| 6. 전달·도메인 지식 갱신 | 적용 가능한 시간대, 예상 오차 |
문제 정의·수집에서 등록 시각만 있고 입장 시각이 없다면 입장 대기 시간을 계산할 수 없다. 이때는 입장 기록을 확보하거나 질문을 등록량 예측으로 바꾼다. 입장 기록은 있어도 이탈이 많다면, 입장자 대기만 예측하는 질문이 방문자의 판단에 충분한지도 재검토한다. 변경 이유를 기록하면 후속 분석의 목표도 함께 정렬된다.
탐색에서 재미있는 패턴을 찾았다면 새 가설로 남긴다. 예를 들어 “목요일의 대기가 짧다”는 패턴을 발견했을 때, 이후의 목요일에도 나타나는지 확인한다. 그리고 상관없을 것 같은 부분을 변경하였을 때, 계속하여 이 패턴이 발견되는지 비교한다.
예측과 추론은 무엇을 알아보려는지가 다르다. 예측(prediction)은 아직 관측하지 않은 대상의 결과를 예상하는 데, 통계적 추론(statistical inference)은 자료로 더 넓은 모집단의 특성이나 관계를 추정하고 그 불확실성을 평가하는 데 초점을 둔다.3
| 구분 | 예시 |
|---|---|
| 예측 | 내일 점심의 특정 등록 구간에서 입장자 평균 대기는 몇 분일까? |
| 추론 | 평일 점심에 입장한 전체 일행의 평균 대기는 얼마일까? 일부 기록으로 추정한 이 평균은 얼마나 불확실할까? |
예측에서 관심 있는 불확실성은 새로 관측할 구간의 대기 시간이 얼마나 달라질 수 있는가다. 추론에서 관심 있는 불확실성은 모집단의 평균을 얼마나 정확히 추정했는가다.
또한, 결과의 전달도 DSLC의 일부이다. EDA 및 평가 결과는 여러 방법으로 표현될 수 있다. 전달용 그래프는 독자가 표/그림을 원활히 해석할 수 있도록 주장을 드러내야 한다.
3.1 사례를 통한 단계 이해
| 작업 | 예시 | 판단할 내용 |
|---|---|---|
| Cleaning | 중복 등록, 음수 시간, 이탈·관측 종료·기록 오류 구분 | 오류인지 실제 현상인지 확인하고 처리 이유 기록 |
| Preprocessing | 시각을 30분 구간으로 묶고 요일 변수를 생성 | 같은 원자료를 어떤 분석 표현으로 바꾸는가 |
| EDA | 날짜별 입장 대기 분포·이탈률·기록 오류를 탐색 | 예상과 다른 패턴이 자료 문제인지 새 가설인지 확인 |
| 구조 탐색 | 식당별 혼잡 패턴을 군집으로 묶음 | 정답 변수를 맞히지 않고 관측 사이의 구조를 찾음 |
| 예측 | 예측 시점의 입력으로 다음 구간 대기 시간을 추정 | 아직 관측하지 않은 정답에서 성능 확인 |
| 추론 | 표본에서 특정 기간 입장자 모집단의 평균 대기 시간과 불확실성을 추정 | 표본이 모집단을 대표하는 과정과 가정 검토 |
4. 프로젝트 셋업
4.1 프로젝트 repository 예시
Python 프로젝트 예시다. 원자료를 어떤 코드로 가공하고 결과를 만드는지, 각 처리의 이유가 무엇인지 기록한다. 이 때, 원자료는 보존하며 실행 가능한 코드·탐색 기록의 구분을 강조한다.4
project/
  README.md                 # 질문, 데이터 확보 방법, 실행 순서, 예상 출력
  CLAUDE.md                 # Claude Code 사용 시 팀 공통 작업 지침
  requirements.txt          # 실행에 사용한 패키지 버전
  .gitignore                # 공개하지 않을 데이터와 개인 환경 파일
  data/
    raw/                    # 내려받은 원본, 직접 수정하지 않음
  docs/
    data_dictionary.md      # 단위, 시점, 결측, 범주 정의
    decisions.md            # 선택 이유, 대안, 변경 이력
  src/
    prepare.py              # 원자료를 분석 가능한 형태로 변환
    evaluate.py             # 기준 방법과 평가 지표 계산
  notebooks/
    01_pilot.ipynb          # 탐색 과정과 결과 해석
  outputs/
    pilot_metrics.csv       # 코드로 다시 생성할 핵심 표
이 예시에서는 prepare.py가 data/raw/의 등록 기록을 읽어 대기 시간을 계산하고,
evaluate.py가 그 자료로 기준 방법의 예측 오차를 구해 outputs/pilot_metrics.csv에
저장한다. README에는 필요한 입력 파일과 두 코드를 실행하는 명령을 순서대로 적는다.
README에는 자세한 안내가 필요하다. 프로젝트 루트에서 실행하는지, 어떤 파일이 입력인지, 어떤 패키지 버전이 필요한지, 결과 파일의 예시 등을 적는다. 실제로 존재하지 않는 명령을 안내용으로만 적어 두지 않는다.
가공 자료를 저장하면 계산 시간을 줄일 수 있지만 원자료나 정제 규칙이 바뀐 뒤 낡은 파일을 사용할 위험이 있다. 그래서 분석 시 원자료를 다시 정제하는 방식을 권장하지만, 정제가 오래 걸려 중간 결과를 저장할 때에는 생성 과정과 갱신을 관리하도록 한다.5 중간 파일을 저장한다면 입력 버전·정제 설정·생성 코드를 함께 기록한다.
4.2 Clean Code와 TDD
Clean Code는 다른 사람이 의도를 이해하고 수정하기 쉬운 코드를 지향한다.
변수·함수 이름에 의미를 담고, 서로 다른 역할의 계산을 구분하며, 같은 로직을 여러 곳에
복사하지 않는다. 주석에는 코드만으로 알기 어려운 선택의 이유를 남긴다.6
예를 들어 process()보다 calculate_wait_minutes()가 하는 일을 더 잘 드러낸다.
TDD(test-driven development)는 기대하는 동작을 테스트로 먼저 적고, 그 테스트를 통과하도록 코드를 만드는 개발 방식이다. 다음 과정을 작은 단위로 반복한다.7
- Red: 원하는 동작의 테스트를 작성하고, 아직 구현되지 않아 실패하는지 확인한다.
- Green: 테스트를 통과시키는 데 필요한 코드를 작성한다.
- Refactor: 테스트가 계속 통과하는지 확인하면서 중복을 줄이고 코드 구조를 정리한다.
대기 시간 함수라면 먼저 “11:50에 등록하고 12:00에 입장하면 10분을 반환한다”는 테스트를 만든다. 이를 통과시킨 뒤, “입장 시각이 없으면 0분이 아닌 결측값을 반환한다”는 합의된 규칙의 테스트를 추가한다. 탐색 중인 분석 전체에 한꺼번에 적용하기보다, 동작을 정할 수 있는 정제·집계 함수부터 시작할 수 있다. 테스트는 정한 규칙대로 코드가 동작하는지 확인한다.
4.3 GitHub로 팀 작업 관리하기
팀의 기준이 되는 GitHub 저장소(repository)를 하나 정하고, 각자 자기 컴퓨터에 복제(clone)해 작업한다. 팀원은 각자의 계정으로 참여하며, 작업마다 담당자와 검토자를 정한다. 분석 담당도 동료의 문서나 코드를 검토(code review)하는 역할을 맡는다.
Git은 파일 변경 이력을 관리하고, GitHub는 그 이력을 공유하고 논의할 공간을 제공한다. commit은 선택한 변경을 로컬 이력에 남기는 것이고, push는 그 커밋을 원격 저장소로 보내는 것이다.8
팀 프로젝트에서는 다음 흐름으로 작은 변경 하나를 끝까지 넘길 수 있다. branch는 작업을 나누는 갈래이고, pull request(PR)는 그 변경을 검토하고 합치자고 제안하는 단위다.9
전체 절차는 GitHub flow, 리뷰 화면과 피드백 방법은 PR 리뷰 시작하기를 참고한다.
4.4 팀 공통 지침
팀이 합의한 작업 규칙을 저장소에 두면 사람과 AI coding agent(e.g., claude code, codex)가 같은 기준을 확인할 수 있다.
| 위치 | 기록할 내용 | 예시 |
|---|---|---|
README.md | 프로젝트 목적과 실행 안내 | 입력 파일 확보 방법, 실행 명령, 예상 출력 |
docs/data_dictionary.md | 변수의 의미 | 등록·호출·입장 시각, 이탈·대기 중·기록 오류의 뜻 |
docs/decisions.md | 분석 선택의 근거와 대안 | 입장자만 계산한 한계, 기록 오류 처리의 비교 결과 |
CLAUDE.md 또는 AGENTS.md | AI가 작업할 때 지킬 공통 규칙 | 원자료 보존, 수정 후 확인할 계산, 리뷰 절차 |
| GitHub Issue·PR | 진행 중인 일과 변경 검토 | 담당자, 완료 조건, 토론과 재실행 결과 |
Claude Code는 CLAUDE.md를 프로젝트 지침으로 읽는다. 파일명은 대문자를 포함해
정확히 쓴다. 개인 컴퓨터의 자동 메모리는 팀원에게 자동 공유되지 않으므로, 팀 전체에
필요한 규칙은 저장소의 지침 파일로 옮겨 함께 검토한다.10
Claude Code를 사용하는 팀은 저장소 루트의 CLAUDE.md에 다음과 같은 짧은 규칙부터
합의할 수 있다. 아래는 식당 프로젝트용 예시이며, 경로와 확인 방법은 실제 프로젝트에 맞춘다.
# 팀 작업 규칙

- 작업 전 README.md의 실행 안내와 docs/data_dictionary.md의 변수 정의를 읽는다.
- data/raw/의 원자료는 직접 수정하지 않는다. 변환 과정은 src/에 코드로 남긴다.
- 결측을 0으로 바꾸거나 행을 제외할 때는 근거와 대안을 docs/decisions.md에 기록한다.
- 정제 코드를 바꾸면 작은 입력으로 계산값, 사용 행 수, 제외 행 수를 확인한다.
- 실행하지 않은 분석을 실행했다고 쓰지 않는다. 확인하지 못한 항목을 보고한다.
- 변경은 작업 branch에서 만들고 PR에 이유와 검증 결과를 적는다.
- 원격 push와 main 병합은 담당 팀원이 변경을 확인한 뒤 요청할 때만 수행한다.
Codex를 함께 쓰는 팀은 공통 규칙의 원본을 AGENTS.md로 둘 수 있다. Codex는 이 파일을
작업 지침으로 읽는다.11
규칙 변경도 코드처럼 PR로 검토한다. 예를 들어 결측 처리 때문에 결과가 달라졌다면,
그 분석의 근거는 decisions.md에 남기고 “정제 변경 시 사용·제외 행 수를 함께 확인한다”는
반복 가능한 규칙을 공통 지침에 추가한다. 한 번의 작업 요청이나 대화 전체를 쌓아 두기보다,
다음 작업에도 필요한 규칙을 남기고 더 이상 맞지 않는 규칙은 고친다.
지침 파일은 AI의 작업을 안내하는 문서이며 강제 실행 장치는 아니다.10 AI가 만든 변경도 담당자가 내용을 설명하고 동료가 검증하는 같은 PR 절차를 거친다.
공식 사용법은 Claude Code의 프로젝트 지침과 메모리, Codex의 AGENTS.md 안내를 참고한다.
노트
이 수업에서는 Claude Code 20달러 Team Plan을 제공한다. 자세한 안내는 PLATO의 QnA 게시판을 확인한다.
5. 준비 사항
5.1 다음 수업까지 논문 읽어오기
노트
아래 논문을 읽어 오세요. 다음 수업에서 함께 다룹니다.
양경주 (2024), 현실적인 데이터 과학의 사례 연구. 서울대학교 석사학위논문.
5.2 Milestone 1 준비 시작
오늘 팀 논의를 출발점으로 4주차 Milestone 1(M1) 제안 발표 준비를 시작한다. 팀당 발표 시간은 10분이다. 발표 전까지 사용할 데이터를 적어도 한 번 직접 열어 보고, 실제로 확인한 내용을 설명해야 한다. 데이터 소개 페이지나 다운로드 링크를 찾는 데서 끝내지 않고, 파일을 읽어 자료의 구조와 주요 변수, 표본을 확인한다.
발표에는 다음 내용을 모두 포함한다.
| 필수 내용 | 준비할 내용 |
|---|---|
| 주제 | 무엇을 알아보거나 해결하려는지, 프로젝트의 질문과 범위 |
| 주제 선정 이유·문헌 조사 | 왜 이 주제를 골랐는지, 관련 연구가 무엇을 했고 우리 팀은 무엇을 해볼지. 참고한 문헌의 출처 포함 |
| 사용할 데이터 | 출처, 확보 상태, 실제로 열어 본 표본과 구조, 주요 변수와 데이터 규모 |
| 앞으로 진행해 볼 내용 | 전처리·탐색·분석의 대략적인 계획과 가장 먼저 시도할 작업 |
| 예상되는 어려움 | 데이터를 열어 보고 발견한 문제, 해결 방향, 수업에서 도움이 필요한 내용 |
| 간트 차트 | 작업별 일정과 담당자, 마일스톤을 포함한 프로젝트 진행 계획 |
예상되는 어려움은 구체적으로 관찰된 문제로 설명한다. 아직 확인하지 못한 위험은 예상임을 구분한다. 발표에서 나온 어려움은 가능한 범위에서 이후 수업의 보완 설명과 강의 내용에 반영할 예정이다.
간트 차트(Gantt chart)는 작업별 시작과 종료 시점을 시간축에 표시하는 일정표다. 문헌 조사, 데이터 확인·전처리, 탐색, 모델링·평가, 발표·보고서 준비를 주차별로 배치하고, 각 작업의 담당자를 적는다. 프로젝트가 진행되면 실제 진척에 맞춰 갱신한다.
6. 팀 구성과 프로젝트 방향 논의
강의 후에는 팀(1-2인)을 꾸리고, 함께 어떤 프로젝트를 해보고 싶은지 이야기한다. 오늘은 관심 있는 주제와 팀의 여건을 알아보고 대략적인 진행 방향을 잡는다.
다음 질문을 중심으로 자유롭게 이야기한다.
| 이야기할 주제 | 함께 생각할 질문 |
|---|---|
| 관심 있는 문제 | 어떤 현상이나 불편을 알아보고 싶은가? 그 결과는 누구에게 도움이 될까? |
| 데이터 후보 | 어떤 자료가 필요할까? 이미 아는 자료나 찾아볼 만한 출처가 있는가? |
| 대략적인 접근 | 무엇을 비교하거나 예측해 보고 싶은가? 가장 먼저 확인할 것은 무엇인가? |
| 협업 방식 | 언제 모이고 어디서 소통할까? 코드와 문서는 어떻게 함께 관리할까? |
| 다음 행동 | 다음 수업 전까지 각자 무엇을 찾아보거나 확인해 올까? |
논의가 끝나면 팀원, 관심 주제 후보, 찾아볼 데이터, 다음 행동을 짧게 메모한다. 아직 의견이 갈리거나 모르는 부분도 남겨 둔다. 오늘 배운 문제 정의와 PCS는 주제 후보를 살펴보는 질문으로 활용하고, GitHub와 공통 지침은 팀의 협업 방식을 정할 때 참고한다. 1인 팀의 경우에도 Github을 통해 프로젝트 관리를 경험해보는 것을 추천한다.
3주차에는 후보 주제와 데이터 탐색 상황을 바탕으로 실현가능성을 함께 검토한다. 자료를 찾았다면 출처와 작은 표본을, 아직 찾지 못했다면 어디를 알아보았고 무엇이 막혀 있는지 얘기한다.
Footnotes
-
Yu, B., & Barter, R. L. (2024). An Introduction to Veridical Data Science. Veridical Data Science, MIT Press. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
Yu, B., & Kumbier, K. (2020). Veridical data science. Proceedings of the National Academy of Sciences, 117(8), 3920–3929. arXiv:1901.08152. ↩ ↩2
-
Yu, B., & Barter, R. L. (2024). The Data Science Life Cycle. Veridical Data Science, MIT Press. ↩ ↩2
-
Barter, R. L. (2019). A quick guide to developing a reproducible and consistent data science workflow. Rebecca Barter. ↩
-
Yu, B., & Barter, R. L. (2024). Setting Up Your Data Science Project. Veridical Data Science, MIT Press. ↩
-
Google. What to look for in a code review. Engineering Practices. ↩
-
Fowler, M. (2023). Test Driven Development. Martin Fowler. ↩
-
Chacon, S., & Straub, B. About Version Control. Pro Git, 2nd edition. ↩
-
GitHub. GitHub flow. GitHub Docs. ↩
-
Anthropic. How Claude remembers your project. Claude Code Docs. ↩ ↩2
-
OpenAI. Custom instructions with AGENTS.md. OpenAI Docs. ↩