Week 1
데이터사이언스 연구, 처음부터 끝까지
이 수업은 강의보다 프로젝트가 주가 된다. 한 학기 동안 팀이 데이터사이언스 연구를 한 사이클 — 주제 선정부터 데이터 수집·정제, 모델링, 분석, 전달까지 — 끝까지 수행한다. 산출물은 최종 발표와 보고서다.
1주차 노트의 목적은 학기 전체에서 여러분이 실제로 밟게 될 전 과정(full process) 을 한눈에 보여주는 것이다. 각 단계의 세부 방법은 해당 주차에 배우지만, 그 전에 전체 지도를 갖고 있어야 어느 지점에서 무엇을 결정하는지, 그리고 프로젝트가 어디서 어긋나는지 알 수 있다.
교재. 이 수업의 주교재는 Bin Yu & Rebecca L. Barter, Veridical Data Science(MIT Press, 2024)다.1 전문이 vdsbook.com 에 무료 공개돼 있다. 세 가지만 먼저 짚는다.
데이터사이언스란 무엇인가? 데이터로 현실의 질문에 답하는 일이다. 서로 다른 세 가지가 맞물린다 — 데이터를 다루는 컴퓨팅, 거기서 결론을 끌어내는 통계·수학, 문제가 놓인 맥락을 아는 도메인 지식. 한 프로젝트 안에서 코드를 짜고, 분석을 설계하고, 결과를 정리해 전달하는 일이 여러 번 오간다. 알고리즘을 고르는 것은 그중 하나일 뿐이다.
그렇다면 “veridical” 은 무엇을 더하나? 보통은 코드가 돌아가고 모델 성능 숫자가 나오면 분석이 됐다고 여긴다. veridical(참된, 현실에 부합하는) data science 는 거기서 멈추지 않는다 — 그 결론이 실제 현실에서도 맞는지를 분석자의 책임으로 못 박는다. 데이터는 현실을 특정한 방식으로만 담고 모델에는 잘 안 보이는 가정이 들어 있어서, 조금 다르게 분석하면 결론이 흔들리거나 새 데이터에서 재현되지 않는 일이 흔하다. 그래서 매 단계에서 현실 · 데이터 · 모델이 서로 어긋나지 않는지 스스로 따져야 한다. 이 점검의 기준이 PCS(§3.0 에서 정의), 점검이 이뤄지는 전체 절차가 데이터사이언스 생애주기(data science life cycle, DSLC)다. DSLC 는 아래 §3 의 파이프라인과 겹친다.
이 책은 무엇을 가르치나? 크게 세 부분이다 — 1부 veridical DS 소개, 2부 데이터 준비·탐색·기술, 3부 모델링. 책의 사례는 각자 자기 분야의 것으로 바꿔 적용한다. 반대로 코딩, 수리통계 이론, 전통적 통계 추론(가설검정·신뢰구간), 윤리·공정성·프라이버시는 다루지 않는다. 이 수업의 범위도 비슷하다.
이번 주 함께 읽기: vdsbook Preface
1. 목표 — 논문지 원고와 학술대회 발표
무엇을 만들어야 하는지 감을 잡기 위해, 다른 학교의 같은 성격 수업을 보자. 서울여자대학교(SWU) 데이터사이언스학과의 캡스톤디자인 2(2025-2학기)는 이 수업과 거의 동일하다 — 학생 팀이 주제 선정부터 데이터 수집·전처리·모델링·분석까지 연구를 한 사이클 수행한다. 한 학기에 6개 팀 전원이 국내 학술대회에 논문을 제출했고, 그중 4개 팀이 수상했다.2
그 팀들의 주제:
- 교통안전 사고 예측 (GraphSAGE 회귀 모델)
- 야구 경기 승패 예측 (공식 규칙 반영)
- 패션 이커머스 리뷰 이미지의 개인정보 노출 탐지
- 위성 궤도 오차 예측 (머신러닝)
- 전기차 충전소 전력 수요 예측
- 감시 드론용 실시간 객체 탐지 (전처리 기법)
우리 목표는 두 단계다.
- 1차 목표 — 학기말 산출물이 KCI(Korea Citation Index, 한국학술지인용색인) 등재 논문지에 투고할 수 있는 수준의 원고가 되는 것. “돌려 봤습니다”가 아니라 명확한 문제 · 확보한 데이터 · 정당한 방법 · baseline 대비 검증된 결과 · 정직한 한계를 갖춘 원고.
- 2차 목표(현실적 최소선) — 국내 학술대회에 발표하는 것. 학술대회 발표는 그 자체로 유효한 성과이면서, 논문지 원고로 확장하는 발판이 된다.
목표로 삼을 만한 KCI 등재 논문지
데이터사이언스 캡스톤(실제 데이터 + 방법 + baseline 비교 + 검증) 성격에 맞는 국문 KCI 등재 논문지들.3
| 논문지 (약칭) | 발행 학회 | KCI | 분야 |
|---|---|---|---|
| 한국컴퓨터정보학회논문지 (JKSCI) | 한국컴퓨터정보학회 | 등재 | CS(computer science) 전반 — AI(artificial intelligence)·데이터·시스템·정보보안·IT(information technology)서비스·콘텐츠. 응용 ML(machine learning)·구현형 논문 다수 |
| 한국정보기술학회논문지 (Journal of KIIT, JKIIT) | 한국정보기술학회 | 등재 | IT 전반(공학일반+CS). 응용 예측·딥러닝 논문 다수, 월간·게재량 많음 |
| 한국산업정보학회논문지 (JKIISR) | 한국산업정보학회 | 등재 | 산업정보시스템 — 산업·현장 데이터 활용, 응용 IT, 사례연구 |
| 한국지능시스템학회논문지 (JKIIS) | 한국지능시스템학회 | 등재 | 지능시스템 — fuzzy·신경망·패턴인식·머신러닝·계산지능·지능제어. 전기공학 카테고리 |
| 정보과학회논문지 (Journal of KIISE, JOK) | 한국정보과학회 | 우수등재 | 국내 CS 플래그십 — 소프트웨어·알고리즘·AI·시스템·이론 전반 |
KCI 논문지는 보통 학술대회 발표 → 논문지 확장이 표준 경로다.
2. 가장 흔한 실패: 의미 없는 결론
목표를 이루려면 무엇을 피해야 하는가. 코드가 안 돌아서 실패하는 경우가 드물다. 대개 다 돌아갔는데도 “그래서 뭐?(so what?)”에 답하지 못해서 실패한다. 전형적인 다섯 가지:
주의
① 아무도 행동을 바꾸지 않는다. 결과가 어떻게 나오든 누군가의 결정이나 이해가 달라지지 않는다면, 그 분석은 무엇을 위한 것인지 다시 물어야 한다.
② 이미 알고 있던 것을 확인했다. “비싼 집이 넓다”, “겨울에 난방비가 는다” 수준의 결론. 새로 알게 되는 것이 거의 없다.
③ 검증되지 않았다. 성능 숫자가 data leakage, test set 오염, 잘못된 교차검증에서 나왔다. 숫자는 크지만 현실에서는 재현되기 어렵다.
④ 표본 밖으로 일반화되지 않는다. 특정 기간·지역·집단에서만 성립하는 결론을 일반적 주장처럼 서술한다(selection bias, distribution shift).
⑤ 유의하지만 하찮다. 지만 효과 크기가 의사결정에 영향을 못 줄 만큼 작다. 통계적 유의성과 실질적 중요성은 다른 개념이다.
하나씩, 나쁜 결론 → 고친 결론.
| 나쁜 결론 | 왜 의미 없나 | 고친 방향 |
|---|---|---|
| “리뷰 감성과 재구매율은 상관이 있다 (, )” | ① 그래서 뭘 하나? ⑤ 효과도 작다 | “부정 리뷰 후 7일 내 CS 응대가 재구매율을 △%p 올린다 — 응대 우선순위 정책에 쓸 수 있음” |
| “우리 모델 정확도 92%” | ③ baseline·검증 정보 없음 | “다수 클래스 78%, 로지스틱 85%, 우리 모델 92% (5-fold, ±1.2%p). 개선의 대부분은 피처 X에서 옴(ablation)” |
| “2023년 서울 데이터에서 A가 B를 예측한다” | ④ 한 도시·한 해 | “2019–2023, 5개 광역시에서 검증. 2020년(코로나)엔 관계가 약해짐 — 한계로 명시” |
이 다섯 가지는 대개 문제 정의·데이터 단계(§3.1–3.2)에서 내린 선택으로 거슬러 올라가고, 그 단계에서 가장 싸게 고칠 수 있다. M1·M2(§5.2)가 그 시점을 붙잡아 주는 이유다.
직관
Nicholas Carlini(best paper award 를 여러 번 받은 머신러닝 연구자, 現 Anthropic)는 좋은 연구의 첫째 기술로 “문제를 고르는 안목(taste)” 을 꼽는다.4 Hamming 의 질문 — “당신 분야에서 가장 중요한 문제가 뭔가, 그런데 왜 그걸 안 하고 있나?” — 을 프로젝트 주제에 던져 보라. “보고서 한 편이 되는 최소 기여가 뭔가”를 묻는 것과는 결과가 크게 다르다.
3. 전 과정 (full process)
데이터사이언스 프로젝트는 대체로 여섯 단계를 거친다. 이 학기 각 주차가 그 단계들에 대응한다. 먼저 그 지도를 그리고(§3.0), 단계별로 무엇을 하고 어디서 어긋나는지 본다(§3.1~3.6). 데이터를 어디서 구하는지는 §3.7.
3.0 CRISP-DM — 공통 언어
CRISP-DM(Cross-Industry Standard Process for Data Mining)5 은 2000년에 정리된 데이터마이닝 프로세스 모델이다. 오래된 문서지만, 데이터사이언스 프로젝트의 진행 방식을 말할 때 여전히 널리 쓰이는 공용어다.
CRISP-DM 이 정의하는 것은 프로젝트가 거치는 여섯 단계(phase) 의 절차다.
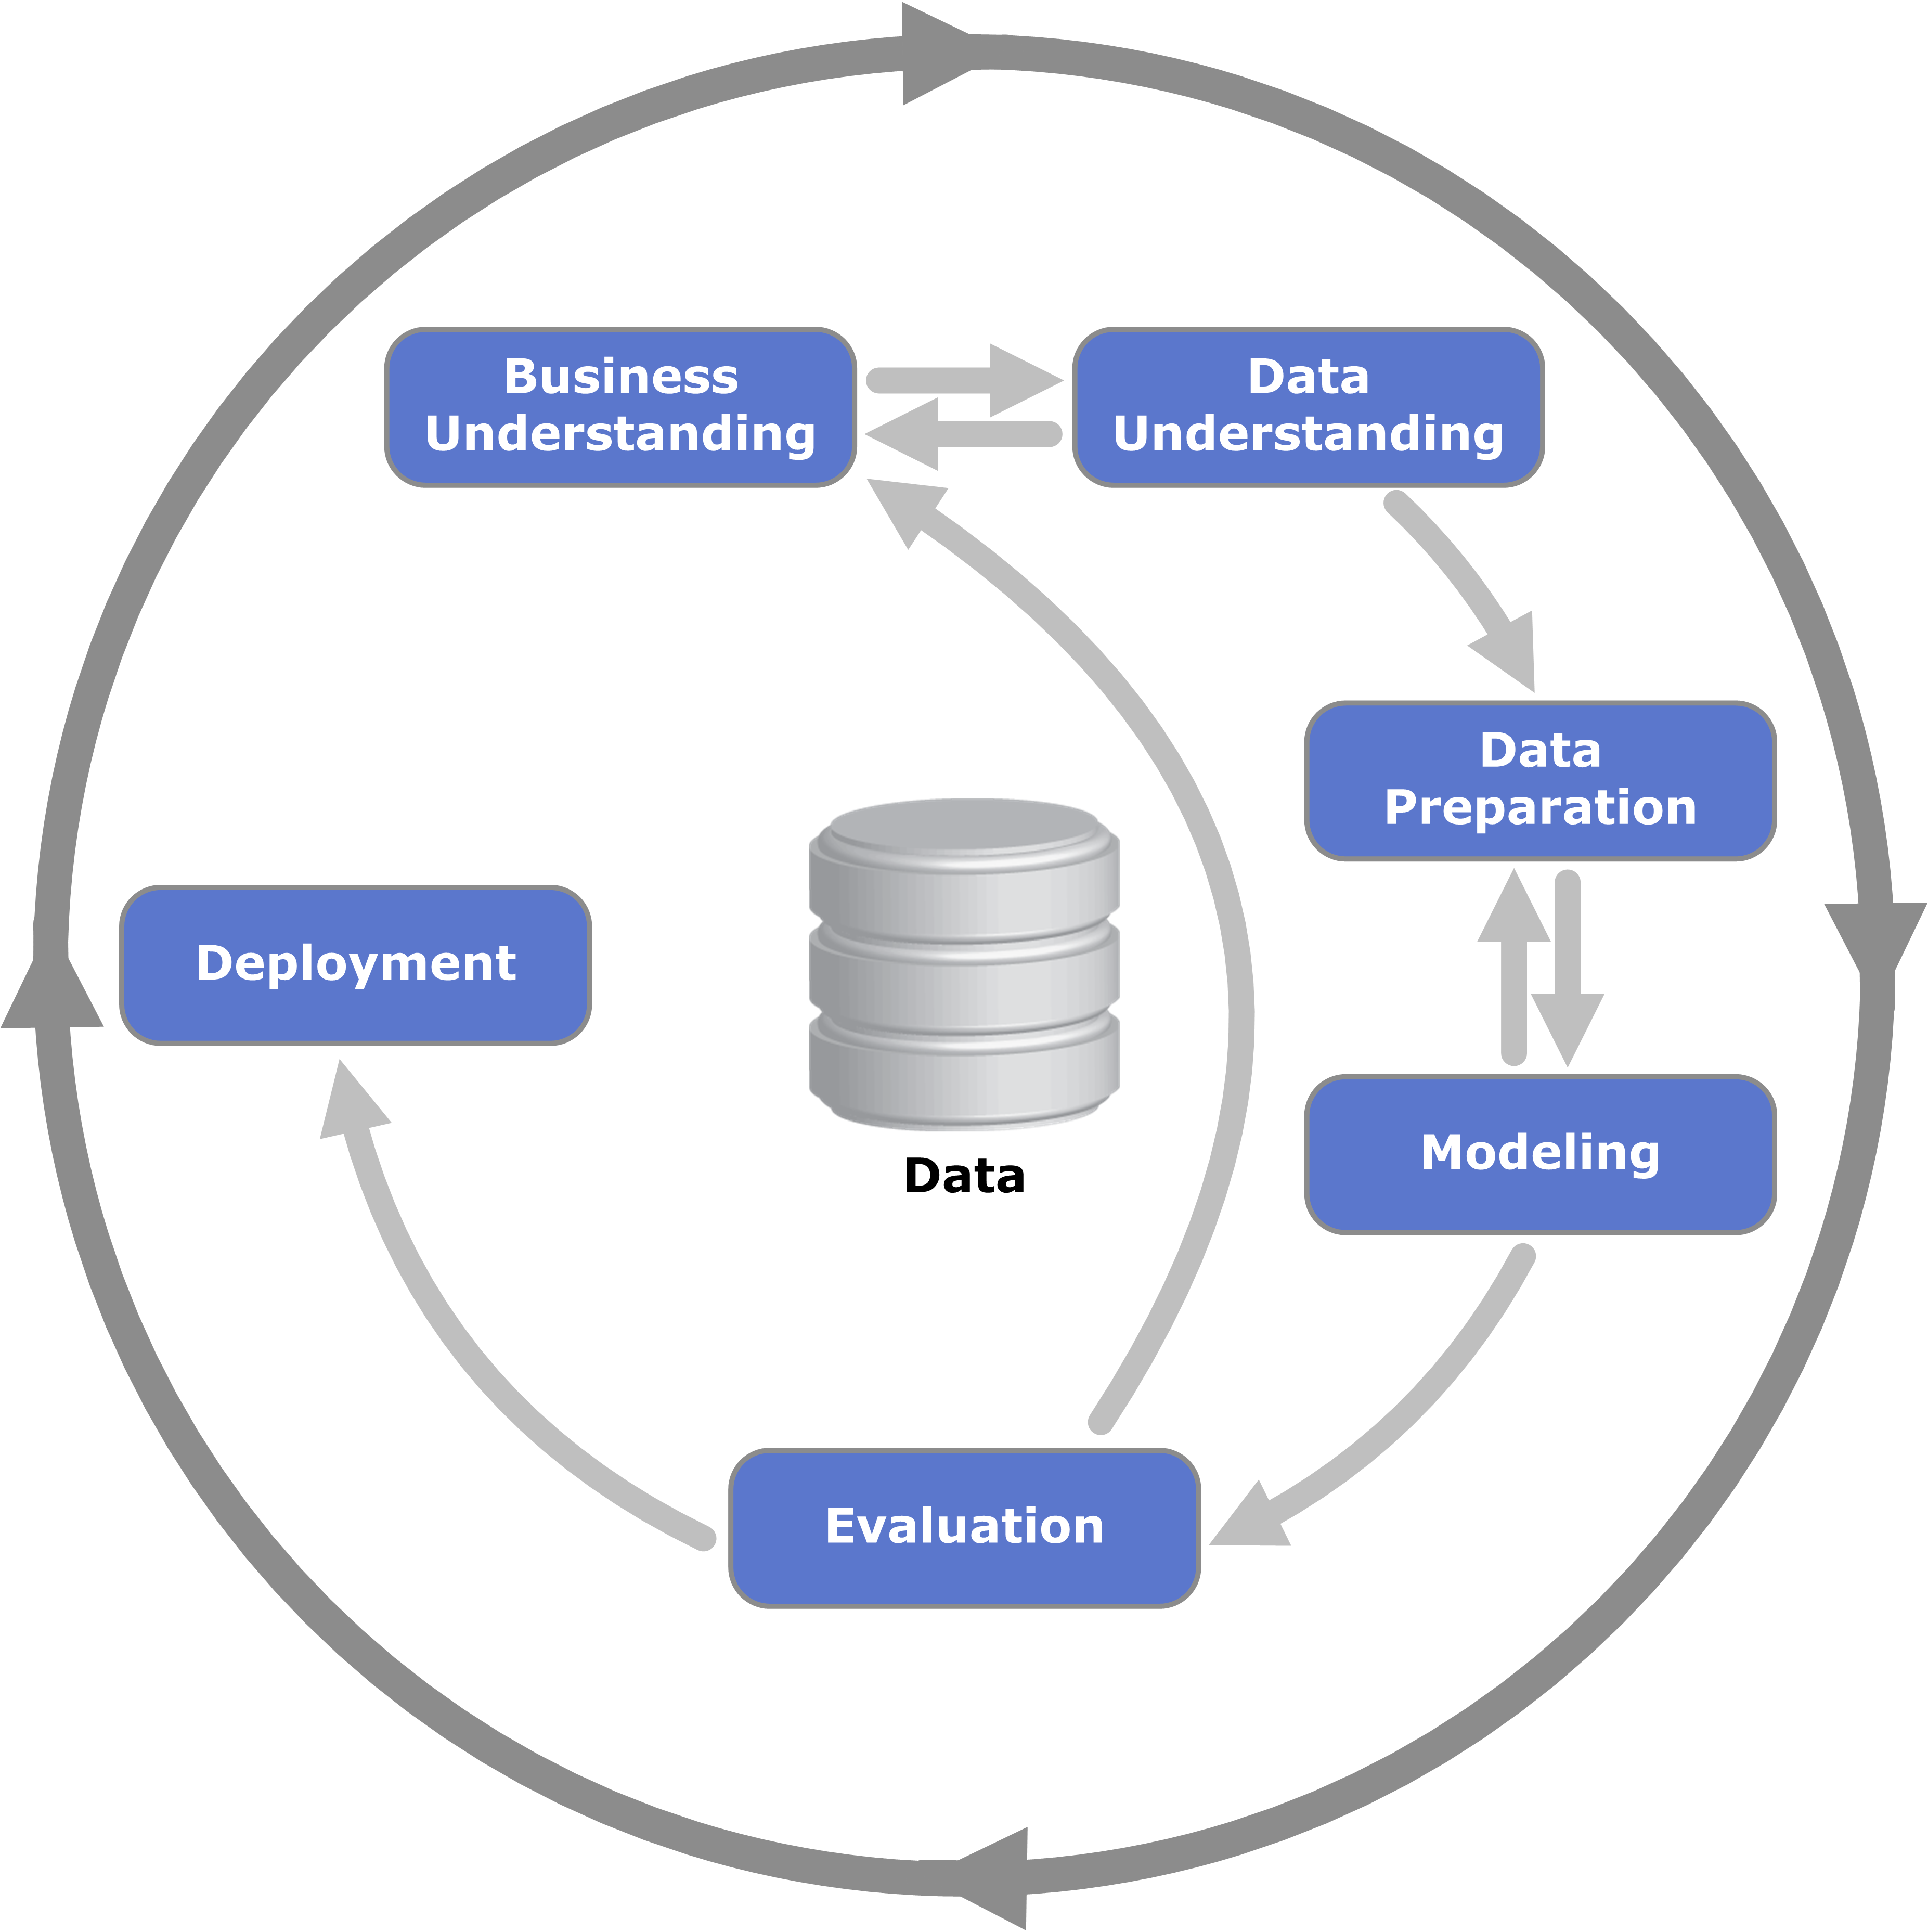
여섯 단계 (Phase)
- Business Understanding (문제 정의) — 무엇을, 왜, 성공 기준은.
- Data Understanding (데이터 이해) — 어떤 데이터가 있고, 그 안에 답할 신호가 있나.
- Data Preparation (데이터 준비) — 정제·변환·분리.
- Modeling (모델링) — 모델링 방법 선택·학습·튜닝.
- Evaluation (평가) — 결과가 믿을 만하고, 애초의 목표에 답하는가.
- Deployment (결과 전달) — 의미 있는 결과물을 쓸 수 있는 형태로 넘긴다. 이 수업에서는 발표 및 보고서.
왜 이걸 쓰나.
- 직선이 아니라 순환. 다이어그램의 화살표가 핵심이다 — Business ↔ Data 사이를 오가고, Evaluation 에서 문제 정의로 돌아가고, 프로젝트가 끝나도 바깥 원을 다시 돈다.
- 문제 정의가 1번. 데이터·모델보다 먼저, 동등한 비중으로.
한계. 2000년 프레임이고 평가의 엄밀성이 약하다 — 그래서 이 노트는 각 단계에 실현가능성·검증 질문을 얹어 보강한다. 이 보강이 곧 교재에서 말한 “veridical”의 의미다.
교재 소개에서 말한 DSLC 가 바로 이 보강을 프레임으로 만든 것이다. CRISP-DM 과 단계 구성은 거의 같지만 강조가 다르다 — 한가운데 비판적 사고를 놓고, 다섯째 단계를 아예 “결과를 의심하기(scrutinization of results)“로 이름 붙인다. 그리고 모든 단계에서 결과가 PCS 를 만족하는지 stress test 한다(아래).1
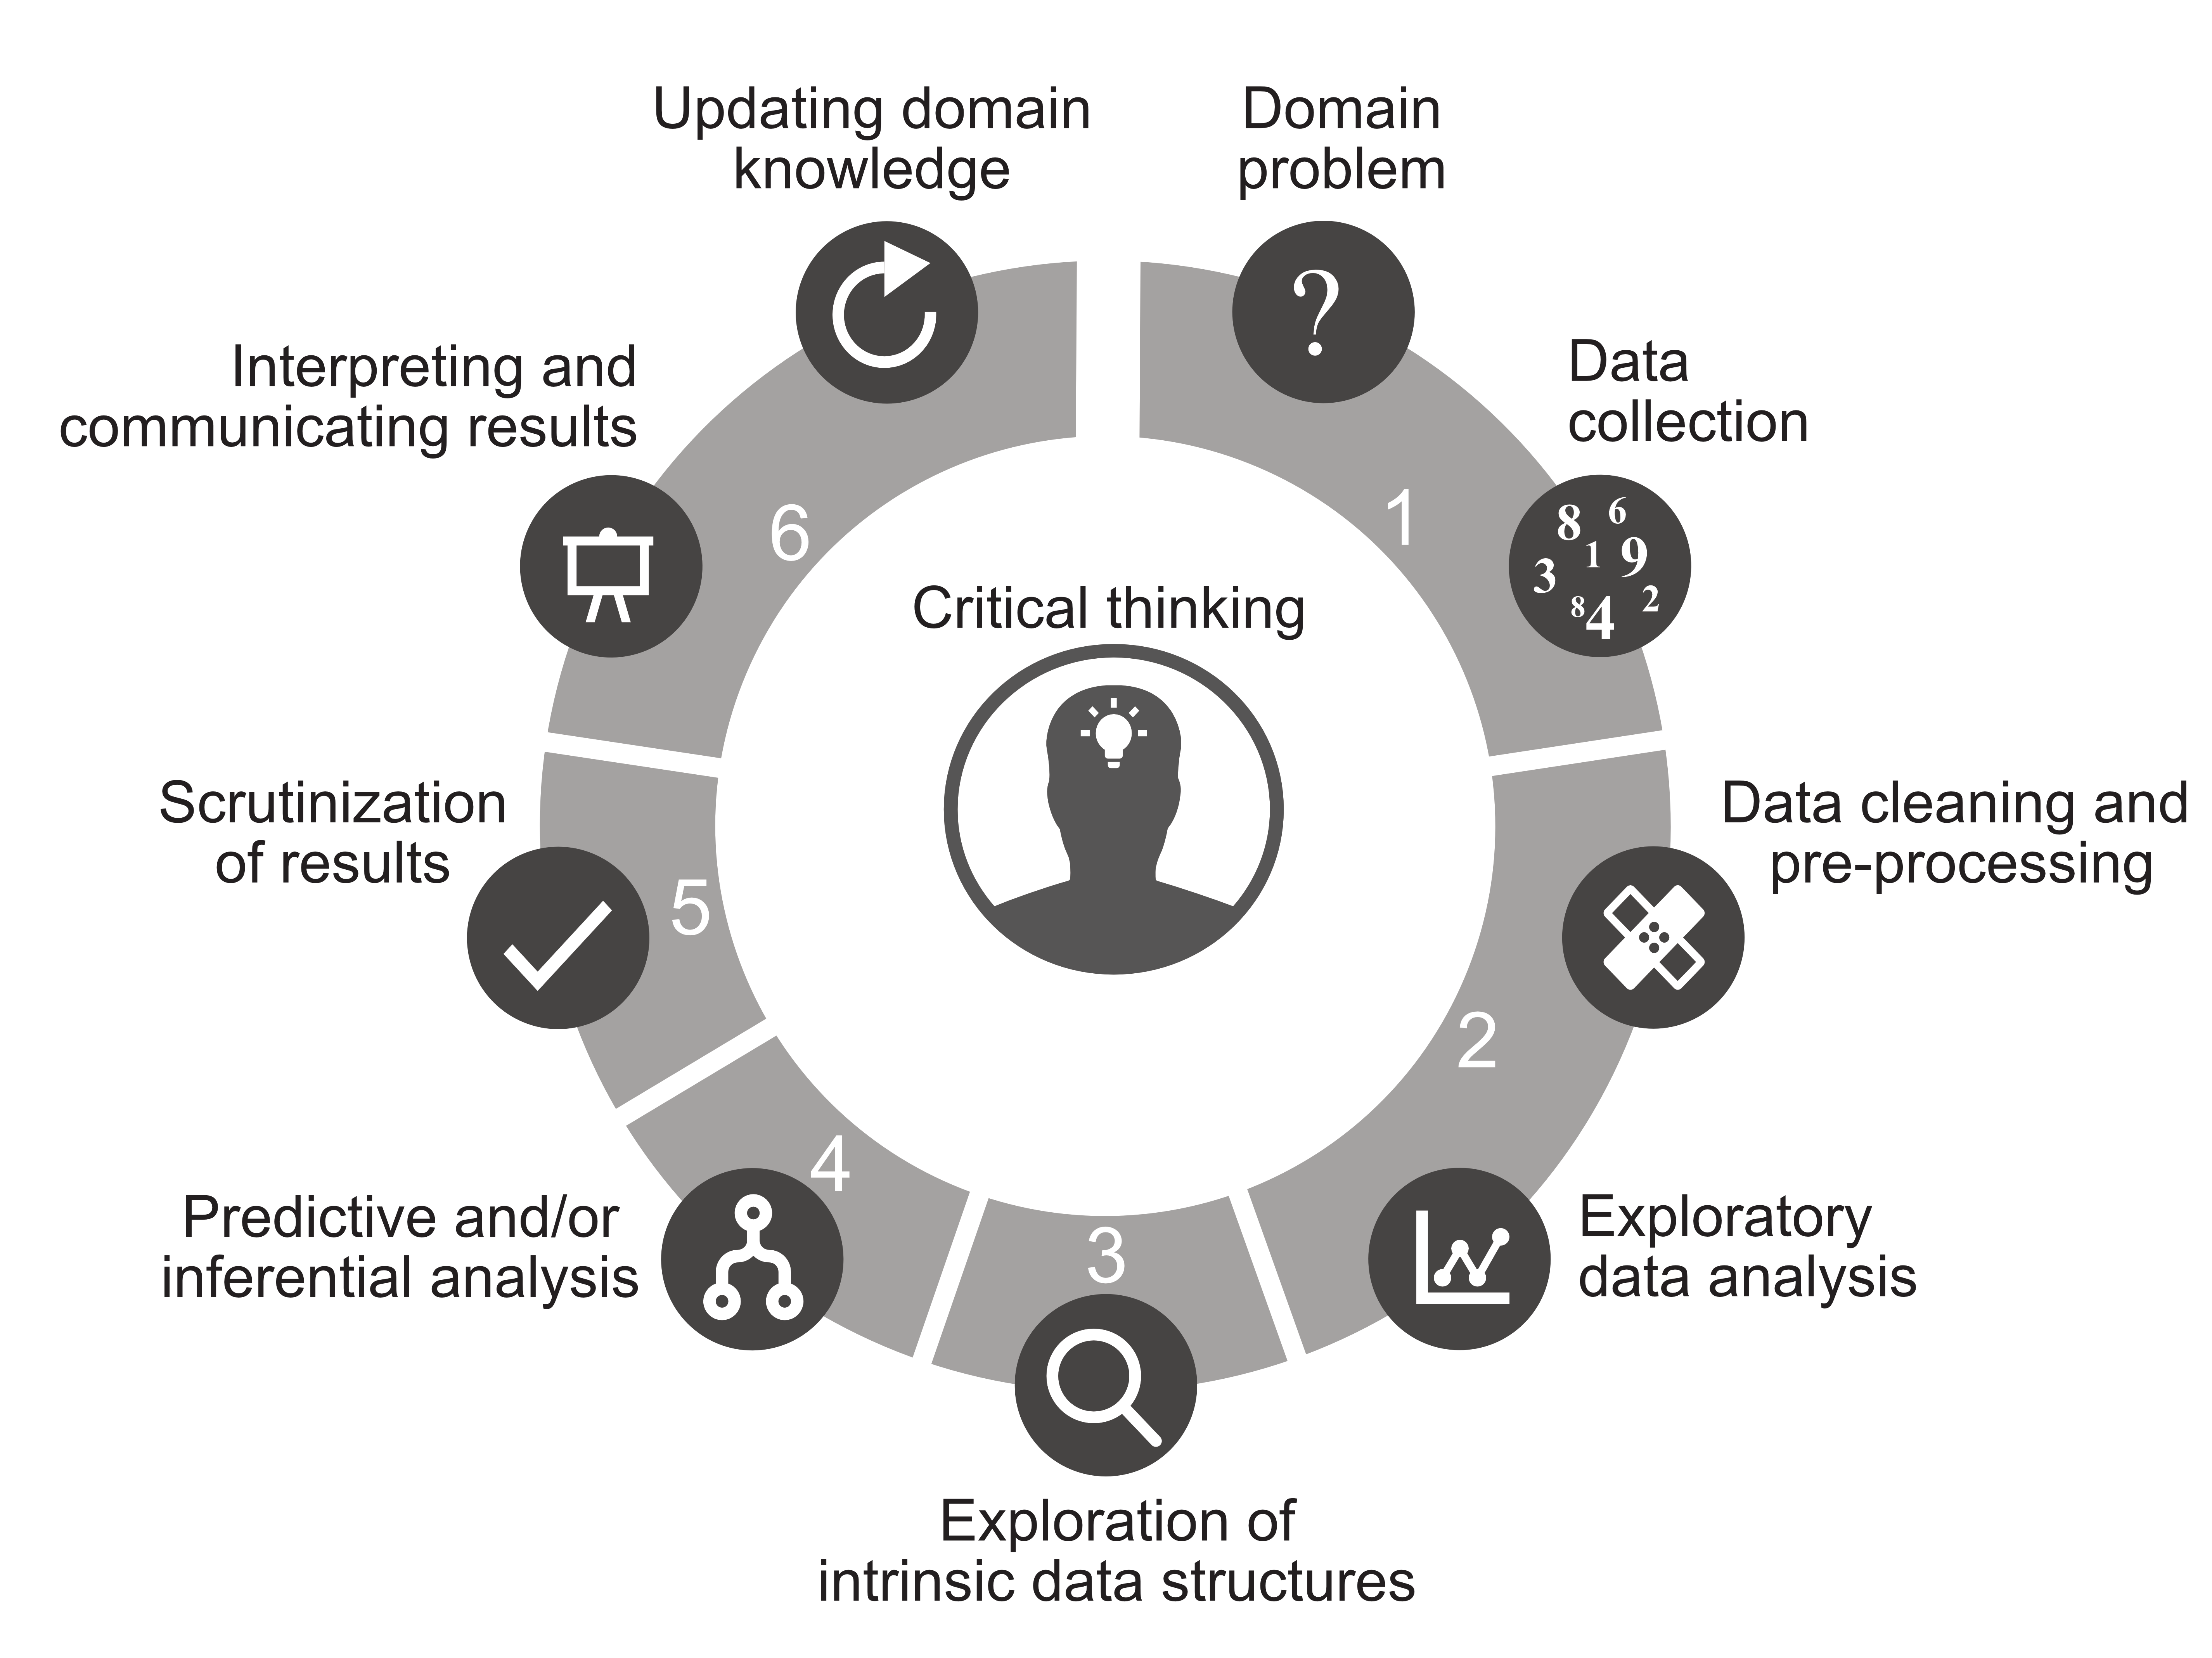
PCS 세 렌즈. 어떤 결과든 이 셋을 통과해야 믿는다.
- 예측가능성(predictability) — 결과가 새 데이터·다른 조건에서도 유지되는가. 샘플 밖에서 확인한다.
- 계산가능성(computability) — 분석을 실제로 재현·검증할 수 있는가. 코드·데이터·난수 seed·환경이 남아 있는가.
- 안정성(stability) — 데이터를 다르게 모으거나 전처리·모델 선택을 합리적으로 바꿔도 결론이 크게 달라지지 않는가.
PCS 를 문제 설정에 실제로 적용하는 방법은 2주차(problem framing) 에서 vdsbook 1–2장과 함께 이어서 다룬다.
3.1 문제 정의 — 2·3주차
하는 일. 막연한 관심(“배달 데이터 재밌겠다”)을 답할 수 있는 질문으로 좁힌다. 무엇을 예측/설명/비교할 것인가, 성공은 어떻게 측정하는가, 이 답으로 누가 무엇을 결정하는가. 질문을 한 문장으로 쓸 수 있을 때까지 좁힌다.
실현가능성 체크.
- 이 질문은 데이터로 답할 수 있는 종류인가? (인과 질문인데 관측 데이터뿐이라면 답이 제한된다)
- 답이 나오면 누군가 다르게 행동하는가? 아니면 §2-①.
- 이미 알려진 답이 아닌가? 선행 조사(§4)로 확인. 아니면 §2-②.
- 결과가 어느 쪽으로 나오든 보고할 내용이 되는가? (“성공해야만 발표거리가 있는” 주제는 위험하다)
- 주어진 기간 안에 팀 역량·자원으로 감당할 범위인가?
주의
여기서 질문을 잘못 정하면 뒤에서 고치는 비용이 크다 — 데이터 수집·분석을 상당 부분 다시 해야 한다. 3주차 “topic feasibility review” 와 4주차 M1(Milestone 1) 이 이걸 거르는 관문이다.
3.2 데이터 이해 — 5·7주차
하는 일. 어떤 데이터가 존재하고, 어떻게 수집하며, 그 안에 질문에 답할 신호가 실제로 있는지 확인한다. 출처, 수집 방식, 변수의 의미(데이터 사전), 결측·이상치, 편향의 원천. 이 단계 산출물은 “우리 데이터는 이렇게 생겼다”를 표·그림으로 보여줄 수 있는 상태.
실현가능성 체크.
- 데이터가 존재하고 접근 가능한가? (공개 데이터인가, API(application programming interface) 한도는, 크롤링이 약관·법·연구윤리에 맞는가)
- 양이 충분한가? 관심 있는 사건이 드물면(불균형) 학습·검증할 표본이 적다 — 부족하다면 더 모으거나 대상 범위를 좁힐 수 있는가?
- 표본이 모집단을 대표하는가? 특정 채널·기간만 모이면 결론이 거기 갇힌다(§2-④).
- 예측에 쓰려는 변수가 예측 시점에 실제로 존재하는가? 결과가 원인에 섞여 들어오면 target leakage — 검증 성능은 부풀고, 배포하면 그만큼 떨어진다.
- 라이선스가 재배포·논문 게재를 허용하는가? (일부 데이터는 결과 공개에 제약이 있다)
3.3 데이터 준비 — 6주차
하는 일. 정제(결측·중복·형식), 변환, 피처 생성, 학습/검증/테스트 분리. 모든 처리 단계를 재현 가능하게 스크립트로 남긴다.
실현가능성 체크.
- 정제 후에도 질문에 답할 만큼 데이터가 남는가?
- train/test 분리를 누수 없이 했는가?
- 처리 파이프라인이 재현 가능한가 — 같은 입력에 같은 출력이 나오는가(seed 고정)?
- 이 단계에서 데이터가 질문을 못 받친다는 게 드러나면 — 지금 §3.1 로 돌아가 질문이나 범위를 바꾼다. 8주차 M2 전에 이 판단을 끝내는 게 이상적이다.
3.4 모델링 — 9·10·11주차
하는 일. 문제 유형에 맞는 방법을 고르고, 학습·튜닝한다. 예: 선형 모델, 시계열, 트리 앙상블, 딥러닝.
실현가능성 체크.
- baseline 이 있는가? “정확도 85%“는 그 자체로는 거의 정보가 없다 — 다수 클래스로 찍기, 간단한 규칙, 선형 모델 대비 얼마나 나은지가 정보다.7
- 평가 지표가 실제 목표와 정합하는가?
- 하이퍼파라미터 탐색을 validation set 에서 했는가, test set 은 마지막에 딱 한 번 건드렸는가?
3.5 평가 — 12·13주차
하는 일. 모델·분석 결과가 믿을 만한지, 그리고 무엇을 의미하는지 판단한다. 숫자 하나가 아니라, 그 숫자가 얼마나 흔들리는지·어디서 무너지는지까지.
실현가능성·타당성 체크.
- 교차검증·반복 실행으로 불확실성(신뢰구간, 표준편차)을 함께 보고하는가?
- 통계적 유의성 ≠ 실질적 중요성. 효과 크기를 함께 본다(§2-⑤).
- 관측 데이터에서 나온 상관을, 개입 가능한 인과처럼 서술하고 있지 않은가(교란 변수)?
- 결과가 데이터 분할·전처리 선택에 얼마나 민감한가 — PCS 의 안정성(§3.0). ablation 으로 “어느 요소가 성능을 만드는가”를 충분히 분해했는가?
3.6 결과 전달 — 14주차 (Demo), 16주차
하는 일. (비)전문가가 이해하고 행동에 옮길 수 있게 전달한다.
체크.
- 청중이 이 결과로 무엇을 하면 되는가가 분명한가?
- 한계를 정직하게 적었는가 — 데이터의 편향, 일반화 범위, 인과 주장 불가 등.
- 보고서의 결론이 “우리가 한 일의 과거형 요약”이 아니라 “그래서 무엇을 배웠나” 에 답하는가.4
- 표·그림 하나하나가 읽는 사람의 질문에 답하는가, 아니면 그냥 있어서 넣었는가?
3.7 데이터를 어디서 구하나
어디서 찾나. 주제가 아무리 좋아도 데이터가 없으면 프로젝트로 세우기 어렵다 — §3.2(데이터 이해)는 여기서 시작한다. 캡스톤에서 현실적으로 쓸 수 있는 출처:
국내 공개 데이터
- 공공데이터포털 (data.go.kr) — 정부·지자체·공공기관의 개방 데이터·API. 교통, 에너지, 환경, 복지, 상권 등.
- AI Hub (aihub.or.kr) — NIA(한국지능정보사회진흥원) 가 구축한 한국어 중심 AI 학습용 데이터셋(음성, 비전, 자연어, 헬스케어 등). 라벨이 붙어 있어 지도학습에 바로 쓰기 좋다.
- KOSIS 국가통계포털 (kosis.kr) — 통계청 및 각 부처의 정형 통계.
- 서울 열린데이터 광장 (data.seoul.go.kr), 각 지자체 데이터 포털 — 지역 단위 실측·행정 데이터.
- 금융·기상·의료 등 도메인 포털 (예: 기상자료개방포털, 건강보험심사평가원 공공데이터).
국제 공개 데이터
- Kaggle Datasets, Hugging Face Datasets (huggingface.co/datasets) — 규모·다양성 최다. 벤치마크와 baseline 이 딸려 있는 경우가 많다.
- UCI Machine Learning Repository, OpenML — 정형 데이터 표준 벤치마크.
- Google Dataset Search, Papers with Code (Datasets) — 흩어진 데이터셋 탐색.
주의
크롤링·API 수집은 5주차에서 별도로 다룬다. 사이트 약관, robots.txt, 개인정보 포함 여부, 저작권을 먼저 확인한다. 무단 수집한 데이터로 낸 결과는 발표·투고에 문제가 된다. 가능하면 명시적으로 개방된 데이터를 우선한다.
4. 연구 논문으로 쓴다는 것
1차 목표가 논문지 원고이므로, 산출물의 형태를 미리 알아 둔다. KCI 등재 논문지의 응용 논문은 대체로 이런 골격이다 — 그리고 각 절이 곧 파이프라인 각 단계의 산출물이다.
| 논문 절 | 답해야 할 질문 | 파이프라인 대응 |
|---|---|---|
| 서론 | 무슨 문제인가, 왜 중요한가, 우리 기여는 무엇인가 | 문제 정의 (§3.1) |
| 관련 연구 | 남들은 무엇을 했고, 무엇이 빠져 있나 | 선행 조사 (아래) |
| 제안 방법 | 데이터·전처리·모델을 재현 가능하게 | 데이터 이해·준비·모델링 (§3.2–3.4) |
| 실험 및 결과 | 설정, baseline, 지표, 결과, ablation | 평가 (§3.5) |
| 논의·결론 | 무엇을 배웠나, 한계, 다음 | 결과 전달 (§3.6) |
선행연구 조사. “이미 알려진 답”(§2-②)을 피하고 기여를 자리매김하려면 필수다.
- 우리 질문에 가까운 선행연구를 충분히 찾아, “무엇을 했나 / 무엇이 아쉬운가”를 정리한다. 그 아쉬움을 우리가 메운다 — 그게 기여다.
글쓰기 — Carlini 의 원칙.4
- 아이디어 하나. 논문은 정확히 한 가지를 말한다. 배경·방법·실험이 모두 그 하나로 수렴한다.
- 서론은 이야기다. 독자가 지금 믿는 것에서 출발해, 우리 결과가 말이 되는 세계로 데려온다.
- 결론은 “그래서 무엇을 배웠나”. 한 일의 과거형 요약이 아니라 성찰(§3.6 과 같은 원칙).
- 구체적 숫자로. “개선했다”가 아니라 “X를 Y%p 개선”.
5. 학기 운영
5.1 팀 구성 및 평가
- 팀 구성 · 협업. 팀을 짜고 협업 워크플로를 정한다 (2주차).
- 평가. 퀴즈 40% (주교재) · 최종 산출물(발표 + 보고서) 40% · 참여도 20%.
5.2 마일스톤과 kill criteria
이 수업은 세 개의 마일스톤에서 실현가능성을 점검한다.
| 시점 | 마일스톤 | 이 관문이 거르는 것 |
|---|---|---|
| 4주차 | M1 — 제안 발표 | 질문이 답 가능한가, 데이터 확보 경로가 있는가, 범위가 현실적인가 |
| 8주차 | M2 — 중간 발표 | 데이터·EDA(exploratory data analysis) 로 “이 방향이 결론을 낼 수 있는가”가 보이는가 |
| 16주차 | M3 — 최종 발표·보고서 | 결론이 믿을 만하고 쓸모 있는가 |
직관
Carlini 의 실행 원칙4: 안 되는 프로젝트는 빨리 죽여라, 그리고 가장 그럴듯한 실패 지점을 먼저 검증하라(de-risk). 손에 익은 작업부터 하지 말고, “데이터에 애초에 신호가 있나” 처럼 프로젝트를 무너뜨릴 수 있는 질문을 먼저 친다.
Kill criteria. M1 제안서에 “이런 조건이 확인되면 이 주제를 접고 대안 X 로 전환한다” 를 미리 적는다. 예: “3주 안에 최소 N개 표본을 확보하지 못하면”, “관심 사건의 비율이 1% 미만이면”, “간단한 baseline 을 유의하게 못 넘기면”.
6. 정리
- 이 수업은 데이터사이언스 연구 한 사이클을 끝까지 수행하는 프로젝트다. 목표는 두 단계 — 1차는 KCI 등재 논문지에 투고할 수 있는 수준의 원고, 2차(현실적 최소선)는 국내 학술대회 발표다(§1).
- 학생 프로젝트의 흔한 실패는 코드가 아니라 의미 없는 결론이다: 행동 불변 · 기지 사실 · 미검증 · 미일반화 · 효과 미미(§2).
- 전 과정은 문제 정의 → 데이터 이해 → 준비 → 모델링 → 평가 → 전달의 반복적 파이프라인이다(§3). 이번 학기 각 주차가 이 칸들에 대응하고, 논문의 각 절과도 대응한다(§4).
- 그래서 이 수업은 문제 정의·데이터 실현가능성을 M1·M2 마일스톤과 kill criteria(§5.2)로 일찍 점검한다.
Footnotes
-
Yu, B., & Barter, R. L. (2024). Veridical Data Science: The Practice of Responsible Data Analysis and Decision Making. MIT Press. 무료 온라인판 vdsbook.com (CC BY-NC-ND). ↩ ↩2
-
서울여자대학교 데이터사이언스학과 (2025. 12.). 「데이터사이언스캡스톤디자인2」 수업 성과 (박민서 교수, 2025-2학기). ↩
-
한국학술지인용색인. KCI 등재 논문지 정보. ↩
-
Carlini, N. (2026). How to win a best paper award (or, an opinionated take on how to do important research). ↩ ↩2 ↩3 ↩4
-
Chapman, P., et al. (2000). CRISP-DM 1.0: Step-by-step data mining guide. SPSS. ↩
-
Kaufman, S., Rosset, S., Perlich, C., & Stitelman, O. (2012). Leakage in data mining: Formulation, detection, and avoidance. ACM Transactions on Knowledge Discovery from Data, 6(4), Article 15. ↩
-
Zinkevich, M. (2017, 이후 갱신). Rules of Machine Learning: Best Practices for ML Engineering. Google. ↩