Week 2
Training engineering (Parallelism을 중심으로)
모델 크기와 학습 토큰 수를 정해 계산량을 추산했어도, 실제 학습 완료 시간은 아직 정해지지 않는다. GPU(graphics processing unit)의 메모리에 무엇을 저장하고, 장치 사이에 무엇을 전달하는지가 실행 가능성과 속도를 결정한다. 분산 LLM(large language model) 학습 서베이1를 바탕으로, 8개 노드에 GPU가 8개씩 있는 환경에서 출발해, 같은 64개 GPU에 데이터와 모델을 어떻게 배치할지 살펴본다.
1. 노드와 GPU
1-1. 8개 노드와 64개 GPU
학습용 서버 8대가 있다고 하자. 노드(node)는 서버 한 대를 뜻하며, 이 예제의 각 노드에는 GPU 8개가 있다. 전체는 GPUs다. 노드는 N0–N7, 각 노드 안의 GPU는 G0–G7로 부르자. 예를 들어, N2:G5는 세 번째 노드의 여섯 번째 GPU다.
| 노드 | 노드 안의 GPU 8개 |
|---|---|
| N0 | G0 · G1 · G2 · G3 · G4 · G5 · G6 · G7 |
| N1 | G0 · G1 · G2 · G3 · G4 · G5 · G6 · G7 |
| N2 | G0 · G1 · G2 · G3 · G4 · G5 · G6 · G7 |
| N3 | G0 · G1 · G2 · G3 · G4 · G5 · G6 · G7 |
| N4 | G0 · G1 · G2 · G3 · G4 · G5 · G6 · G7 |
| N5 | G0 · G1 · G2 · G3 · G4 · G5 · G6 · G7 |
| N6 | G0 · G1 · G2 · G3 · G4 · G5 · G6 · G7 |
| N7 | G0 · G1 · G2 · G3 · G4 · G5 · G6 · G7 |
GPU 하나의 메모리가 80 GB라고 가정하면 노드 하나의 합계는 640 GB, 전체 합계는 5,120 GB다. 이 합계가 한 GPU에서 바로 쓸 수 있는 하나의 메모리가 되는 것은 아니다. 각 GPU의 용량 안에 필요한 값이 들어가도록 배치하고, 다른 GPU와의 데이터 송수신이 필요할 때 어떻게 가져올지 정해야 한다.
1-2. 노드 내부와 노드 사이
여기서는 통신 범위를 다음처럼 구분한다.
| 범위 | 예제 | 값이 이동하는 곳 |
|---|---|---|
| 노드 내 통신(intra-node) | N0:G0 ↔ N0:G1 | 같은 서버 안의 GPU 연결 |
| 노드 간 통신(inter-node) | N0:G0 ↔ N1:G0 | 서버 사이의 네트워크 |
보통 이런 환경에서는 노드 내 통신에 더 높은 대역폭과 낮은 지연을 기대하므로, 자주 큰 값을 주고받는 계산을 같은 노드에 모으는 배치를 먼저 검토한다. 다만 연결 속도, GPU와 네트워크 인터페이스의 배치, 다른 작업의 통신에 따라 실제 비용은 달라진다. GPU 개수뿐 아니라 연결 구조(topology)도 학습 설정의 일부다.1
1-3. 하드웨어와 병렬화의 관계
하드웨어 배치가 같아도 역할은 다르게 줄 수 있다. 모델 전체가 GPU 하나에 들어간다면 64개 GPU에 복제본을 두고 서로 다른 데이터를 읽힐 수 있다. 모델 하나를 8개 GPU에 나누어야 한다면 노드 하나가 모델 하나의 계산을 맡고, 그 묶음을 8개 운영할 수 있다. 더 큰 모델은 여러 노드가 함께 담당할 수도 있다.
따라서 각 예제에서 세 가지를 확인한다. 어느 GPU가 무엇을 저장하는가, 같은 입력을 함께 계산하는가 서로 다른 입력을 계산하는가, 어떤 값이 노드 경계를 넘는가? 먼저 N0:G0 하나의 메모리를 계산하고, N0의 8개 GPU로 확장한 뒤, N0–N7 전체를 연결하자.
대규모 학습에서는 데이터·모델·시퀀스의 계산을 여러 방향으로 나누고, 이러한 병렬화 방법을 조합한다. 먼저 각 방법이 해결하는 문제를 살펴본 뒤 하나의 학습 구성으로 묶어 보자.
2. 학습 메모리와 정밀도
2-1. 부동소수점과 정밀도
지금까지 weight(가중치)와 activation을 실수로 썼지만, 컴퓨터는 무한한 자릿수를 저장할 수 없다. Bit는 0 또는 1 한 자리, byte는 8 bits다. FP32는 수 하나에 32 bits, 즉 4 bytes를 쓰는 부동소수점(floating-point) 형식이다. FP16과 BF16(bfloat16, brain floating point)은 각각 16 bits, 즉 2 bytes를 쓴다.
부동소수점은 과학적 표기 처럼 자릿수와 크기를 나누어 담되, 이진수를 사용한다. 부호는 양수·음수를, 지수(exponent)는 표현 범위를, 가수(mantissa)는 같은 크기에서 얼마나 촘촘히 값을 구분하는지, 즉 정밀도(precision)를 정한다.3
| 형식 | 부호 bits | 지수 bits | 가수 bits | 수 하나의 크기 |
|---|---|---|---|---|
| FP32 | 1 | 8 | 23 | 4 bytes |
| FP16 | 1 | 5 | 10 | 2 bytes |
| BF16 | 1 | 8 | 7 | 2 bytes |
여기서는 비트 패턴을 외우기보다 같은 16 bits를 어디에 배분했는가를 보자.
- FP16은 FP32보다 지수도 가수도 줄였다. 최대 유한값은 65,504다. 계산 결과가 범위를 넘으면 overflow가, 너무 작으면 정밀도가 줄거나 0으로 반올림되는 underflow가 생길 수 있다.
- BF16은 FP32와 지수 bits가 같아 표현 범위가 비슷하다. 대신 FP16보다 가수가 짧아 같은 크기에서 구분할 수 있는 값의 간격이 넓다. 그러나 정밀도가 낮아 정보가 사라질 수 있다.
BF16으로 가중치를 저장하면서 매번 작은 업데이트를 바로 더하면 변화가 사라질 수 있다. 그래서 mixed precision은 연산과 저장 항목에 맞게 정밀도를 섞는다. 예를 들어 행렬곱은 BF16 입력으로 수행하되 누적은 FP32로 하고, optimizer의 갱신용 가중치(master weight)와 상태를 FP32로 유지한다. 이때 작은 변화는 master weight에 누적되고, 계산에 쓸 때 낮은 정밀도로 변환한다.4
FP16 학습에서는 작은 gradient가 0이 되는 것을 줄이기 위해 loss scaling도 사용한다. Loss에 큰 상수를 곱해 역전파(backpropagation)하고, optimizer 갱신 전 gradient에서 그 배율을 되돌리는 방식이다. BF16에서는 넓은 범위 덕분에 보통 필요하지 않지만, 반올림 오차나 불안정한 학습까지 없어지는 것은 아니다.5
이제 “8B 모델이 몇 GB인가”는 파라미터 수뿐 아니라 무엇을 어떤 형식으로 저장하는가의 문제다. 낮은 정밀도는 저장·전송량을 줄이고 지원 하드웨어에서 연산을 빠르게 할 수 있지만, 자료형(dtype)과 실제 속도는 구현에 따라 확인해야 한다.
2-2. 메모리 구성
8B 파라미터를 각각 2 bytes로 저장하면 16 GB다. 이 모델을 N0:G0의 80 GB 메모리에서 학습할 수 있을까? 아직 계산에 넣지 않은 항목이 있다. Backward를 위해 보관하는 중간 활성값(activation), 가중치마다 생기는 gradient, optimizer가 유지하는 상태(optimizer state)를 저장해야 한다.
다음은 BF16 가중치·gradient, FP32 master weight와 Adam의 두 상태를 사용하는 예시 구성이다. 구현마다 dtype과 master weight 유지 여부가 달라져 실제 사용량은 달라진다. GB는 bytes 기준이다.
Adam은 파라미터마다 gradient의 1차 모멘트와 2차 모멘트 두 값을 유지한다. 이 두 모멘트도 master weight처럼 FP32로 유지하면 파라미터당 bytes다.
| 저장 항목 | 파라미터당 bytes | 8B에서의 크기 |
|---|---|---|
| BF16 가중치 | 2 | 16 GB |
| BF16 gradient | 2 | 16 GB |
| FP32 master weight | 4 | 32 GB |
| Adam의 1차·2차 모멘트 | 8 | 64 GB |
| 합계 | 16 | 128 GB |
Activation은 입력의 크기와도 함께 늘어난다. 한 GPU가 한 번에 처리하는 작은 배치(microbatch)에 시퀀스 개를 넣고 길이가 , hidden dimension이 라면, 모양이 인 BF16 텐서 하나의 저장량은 다음과 같다.
, , 이면 bytes, 즉 32 MiB다. MiB(mebibyte)는 bytes다. 길이를 8,192로 늘리면 같은 텐서는 128 MiB가 된다. 실제 backward에는 여러 층의 내부 중간값도 필요하므로, 이 값을 전체 activation 메모리로 사용하지 않는다. Attention 구현과 어떤 중간값을 저장·재계산하는지에 따라 최대 사용량이 달라진다.6
위 표의 model state 128 GB에는 gradient 16 GB도 포함되어 있다. Gradient를 제외한 가중치·master weight·Adam 상태는 112 GB다. 이 상태들이 이미 초기화되어 있고, step 시작 전에 gradient tensor를 해제하는 경우를 보자. 아래는 충분한 메모리가 있다고 가정한 저장량 예제이며, 80 GB GPU 하나에서 실행 가능한 구성은 아니다. 모델을 두 블록 로 단순화하고, 각 블록의 backward를 위해 저장한 입력·내부 중간값을 로 표기한다. 이 값들은 블록 출력 하나와 같지 않다.
| 시점 | 메모리에 있는 주요 항목 | 해제 가능한 중간값 |
|---|---|---|
| Forward 시작 | 상주 상태 112 GB | 이전 step의 gradient는 이미 해제 |
| 블록 1 forward 후 | 상주 상태 + | — |
| 블록 2 forward 후 | 상주 상태 + | — |
| 블록 2 backward 후 | 상주 상태 + + 블록 2 parameter gradient | 중 더 이상 쓰지 않는 값 |
| 블록 1 backward 후 | 상주 상태 + 전체 parameter gradient 16 GB | 중 더 이상 쓰지 않는 값 |
| Optimizer step | 합계 128 GB의 상태로 가중치 갱신 | 갱신 후 gradient 해제 가능 |
표에는 입력·loss 계산·activation의 gradient·연산 및 통신용 임시 buffer를 모두 표시하지 않았다. Gradient buffer를 계속 재사용하면 시작 시점부터 그 공간도 차지하며, Adam 상태를 첫 갱신 때 만들면 초기 step의 흐름도 달라진다. Peak memory는 각 시점에 동시에 살아 있는 상태·activation·임시 buffer의 합 중 최댓값이다. 항목별 최대가 같은 시점에 생긴다고 가정하거나, forward 마지막이 항상 전체 peak라고 판단하지 않는다.
파라미터 수가 같아도 microbatch나 context를 키우면 메모리가 부족해질 수 있다. 따라서 학습 상태가 메모리에 들어가는가와 처리량(throughput), 즉 초당 처리하는 유효 토큰 수가 충분한가를 함께 확인한다.
2-3. Gradient checkpointing
Backward에 필요한 중간 결과 중 일부만 저장하고 나머지는 필요할 때 재계산하는 방법을 Gradient checkpointing이라고 한다. Activation checkpointing이라는 이름도 같은 기법을 가리킨다. 이름에 gradient가 있지만 저장을 줄이는 대상은 주로 activation이다. 추가 연산으로 저장 공간을 줄인다.78
네 블록을 통과하는 계산을 x → h₁ → h₂ → h₃ → h₄라고 하자. 실제 backward에는 블록 내부 중간값도 필요하다. 블록 두 개씩 checkpoint 구간으로 묶으면 구간 입력인 x와 h₂를 보관하고 내부 중간값을 필요할 때 다시 만들 수 있다.
| 시점 | 일반적인 저장 방식 | 두 블록씩 checkpoint하는 예 |
|---|---|---|
| Forward | 각 블록의 backward에 필요한 중간값 저장 | 구간 입력을 저장하고 내부 값은 보관을 줄임 |
| 뒤 두 블록 backward | 저장된 중간값 사용 | h₂에서 뒤 구간을 재실행해 필요한 값 복원 |
| 앞 두 블록 backward | 저장된 중간값 사용 | x에서 앞 구간을 재실행해 필요한 값 복원 |
줄어드는 것은 주로 activation이며 가중치나 옵티마이저의 state가 자동으로 줄어들지는 않는다. 모든 블록에 적용하면 재계산량도 커질 수 있으므로, 큰 activation을 만드는 구간부터 적용하고 peak memory와 실행 시간을 비교한다. 같은 microbatch에서 step이 느려져도, 확보한 메모리로 더 큰 microbatch를 처리할 수 있다면 전체 처리량은 다시 측정해야 한다.
2-4. Attention 메모리와 FlashAttention
길이가 늘 때 모든 중간 텐서가 같은 비율로 커지지는 않는다. Attention score를 명시적으로 만드는 구현에서는 head 하나에 행렬이 생긴다. Batch 크기가 , query head 수가 이고 이 행렬을 2 bytes씩 저장한다면 다음과 같다.
, 에서 길이 2,048이면 512 MiB, 길이 8,192이면 8 GiB다. GiB(gibibyte)는 bytes다. 길이가 네 배일 때 이 행렬 하나는 16배로 커진다. 이는 softmax 결과와 다른 중간값, 전체 층의 메모리를 모두 합한 값은 아니다.
FlashAttention은 작은 블록의 score만 계산해 사용하고 버리므로, score·확률 행렬 전체를 저장하지 않는다. 여기서는 2022년 FlashAttention 1을 기준으로 설명한다.9
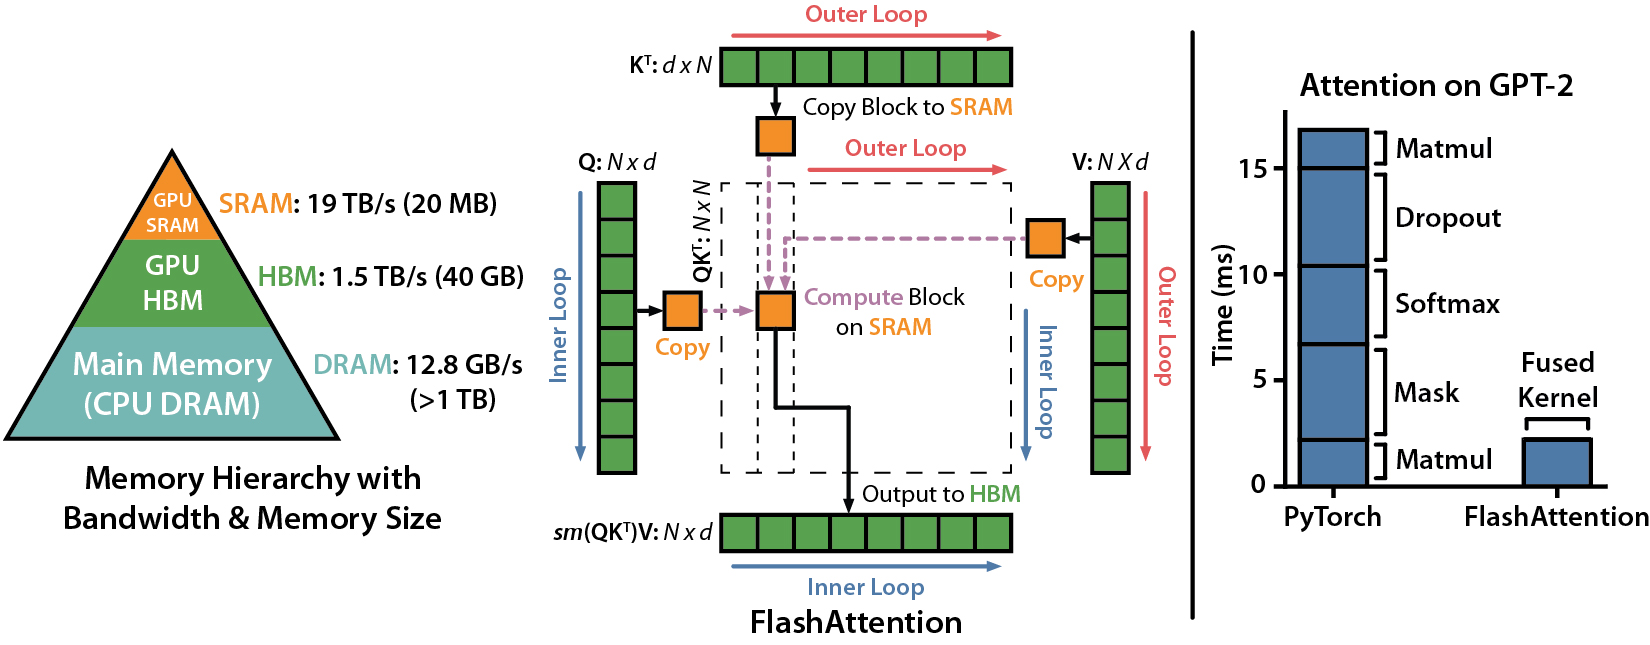
그림 왼쪽의 HBM(high-bandwidth memory)은 GPU의 큰 저장 공간이고, SRAM(static random-access memory)은 칩 내부의 작고 빠른 공간이다. FlashAttention 1은 가운데 그림처럼 K·V 블록을 SRAM에 올린 뒤 여러 Q 블록에 재사용하며, softmax 통계와 출력을 조금씩 갱신한다. 이 과정에서 큰 attention 행렬 전체를 HBM에 저장하지 않아 메모리 사용량과 데이터 이동을 줄인다. Attention의 계산 결과는 반올림 오차 범위에서 유지되며, 오른쪽 그래프는 이러한 방식으로 attention 연산 시간이 줄어든 실험을 보여준다.9
심화: Kernel fusion은 왜 빨라지는가?
GPU에서 kernel은 많은 데이터를 병렬로 처리하도록 실행하는 프로그램이다. 덧셈·곱셈 같은 연산을 각각 별도 kernel로 실행하면, 앞 연산의 결과를 GPU 메모리에 쓴 뒤 다음 kernel이 다시 읽는다. Kernel fusion은 이어지는 연산을 하나의 kernel 안에서 처리해 중간값의 저장·읽기와 kernel 실행 요청(launch) 횟수를 줄이는 방법이다.13
예를 들어 각 원소에 대해 을 계산한다고 하자. 곱셈·덧셈·최댓값 연산을 각각 실행하는 경우와 하나로 묶는 경우를 비교할 수 있다.
| 실행 방식 | 데이터 흐름 | Kernel 실행 횟수 |
|---|---|---|
| 분리 | 읽기 → 저장 → 읽기 → 저장 → 읽기 → 저장 | 3회 |
| Fusion | 읽기 → 칩 내부에서 곱셈·덧셈·최댓값 계산 → 저장 | 1회 |
가 FP32 원소 100만 개라면 배열 하나는 4 MB다. 중간 배열을 매번 GPU의 전역 메모리에 쓰고 다시 읽는 단순 계산에서는 분리 실행이 배열 6개분인 24 MB, fusion이 2개분인 8 MB를 읽고 쓴다. 여기서는 캐시 효과·스칼라 상수·backward용 저장을 제외했다. 실제 HBM 전송량이나 실행 시간이 정확히 3분의 1이 된다는 뜻은 아니다. 원소별 산술 연산은 같아도 데이터를 옮기는 비용은 줄일 수 있다는 예다. Fusion에서는 중간값을 레지스터 같은 칩 내부 저장 공간에 잠시 두고 다음 계산에 바로 사용한다.
FlashAttention 그림 오른쪽의 Fused Kernel도 이 원리와 연결된다. 행렬곱·mask·softmax·dropout·다음 행렬곱을 단계마다 큰 행렬로 저장하는 대신, 블록 안에서 이어서 처리한다. 다만 attention의 softmax는 여러 key의 score를 함께 정규화해야 한다. FlashAttention은 블록 분할과 정규화 통계 갱신을 fusion과 결합해 전체 attention 행렬을 저장하지 않고도 계산을 이어 간다. Backward에서 필요한 값의 재계산까지 포함한 설계다.9
PyTorch의 torch.compile은 결합 가능한 연산을 찾아 이런 최적화를 적용할 수 있다. Python 코드를 한 줄로 쓰는 것만으로 kernel이 하나가 되는 것은 아니며, 모든 연산이 자동으로 합쳐지는 것도 아니다. 적용할 때는 첫 컴파일 시간을 구분하고, 준비 실행 이후 같은 입력·정밀도에서 출력과 gradient가 허용 오차 안에서 일치하는지, 학습 step 시간과 메모리 사용량이 개선되는지 비교한다.14
3. 통신과 데이터·상태 분산
3-1. 장치 간 통신
메모리를 나누어 저장하면 필요한 값을 주고받아야 한다. 이후 병렬화 설명에서 사용할 통신 연산을 먼저 구분하자. 다음 표에서 reduce는 합산을 뜻한다. 평균 gradient가 필요하면 합산 결과를 적절한 수로 나누는 과정도 포함한다.
| 통신 연산 | N0의 GPU 8개가 하는 일 |
|---|---|
| All-reduce | 각자의 값을 합산하고 합산 결과를 모두가 받는다. |
| All-gather | 각자 가진 조각을 모아 모두가 전체를 받는다. |
| Reduce-scatter | 값을 합산한 뒤 결과의 서로 다른 조각을 나누어 받는다. |
| All-to-all | 각 장치가 목적지별로 다른 조각을 보내고, 다른 장치들에서 자기 몫을 받는다. |
예를 들어 N0:G0–G7이 각각 스칼라 gradient 1–8을 가졌다면 all-reduce 합은 36이며, 각 GPU가 36을 받는다. 평균이 필요하면 8로 나누어 4.5를 사용한다. 같은 연산에 N1의 GPU도 참여시키면 노드 사이로도 값이 이동한다. 연산 이름은 값을 합치거나 나누는 방식을, 참여 GPU의 배치는 통신이 지나갈 경로를 정한다.
통신 시간에는 메시지를 보내기 시작하는 지연(latency)과 데이터를 전송하는 시간이 함께 들어간다. 작은 통신을 너무 잘게 나누면 지연이 누적되고, 큰 tensor를 자주 보내면 대역폭(bandwidth)이 중요해진다. 그래서 같은 GPU 수라도 장치 연결과 통신 빈도가 다르면 처리량이 달라진다.1
3-2. DP
가장 먼저 생각할 방법은 같은 모델을 GPU마다 복제하고 서로 다른 데이터를 읽히는 것이다. 이를 DP(data parallelism)라고 한다. PyTorch의 DDP(distributed data parallel)는 이 방식의 대표적인 구현이다.15
먼저 모델과 학습 상태가 GPU 하나에 들어가는 경우를 가정한다. N0 안에서 G0–G7이 같은 모델을 복제하고 서로 다른 배치를 처리하면 DP=8이다.
N0:G0: 모델 θ + 배치 0 → gradient g₀
N0:G1: 모델 θ + 배치 1 → gradient g₁
  …
N0:G7: 모델 θ + 배치 7 → gradient g₇
             ↓ 노드 내 all-reduce와 평균
        8개 GPU가 같은 가중치 갱신
유효 토큰 수가 같다면 이다. 배치마다 채점하는 토큰 수가 다르면 token 단위 평균을 맞추도록 가중한다. 이제 N1–N7에도 복제하면 DP=64가 된다. GPU마다 서로 다른 데이터를 처리하고, gradient를 모든 복제본 사이에서 동기화하므로 노드 간 통신도 필요하다. 구현은 노드 내부와 노드 사이의 통신을 조합할 수 있다.
DDP는 gradient를 동기화하지만, 입력 데이터를 GPU별로 자동 분할하지는 않는다. 서로 다른 샘플을 읽도록 DistributedSampler나 데이터 파이프라인에서 분할을 설정해야 한다. 모든 GPU가 같은 샘플을 반복해서 읽으면 기대한 만큼 서로 다른 학습 데이터를 처리하지 못한다.15
DP의 장점은 서로 다른 입력을 동시에 처리하는 것이다. 하지만 단순 복제에서는 GPU마다 전체 가중치와 optimizer 상태를 유지하므로, 모델 하나의 메모리가 부족한 문제는 그대로다. 또한 backward 과정에서 gradient를 주고받는 시간이 든다.
3-3. Gradient accumulation
한 번에 큰 배치를 넣기 어렵다면 작은 microbatch 여러 개의 gradient를 누적(gradient accumulation)한 뒤 optimizer를 한 번 갱신할 수 있다. 예를 들어 한 GPU에서 시퀀스 16개를 한 번에 처리하는 대신 2개씩 8회 처리한다. 목표 batch를 유지하면서 한 번에 보관할 activation을 줄이는 것이다. Microbatch를 그대로 둔 채 누적 횟수만 늘리면 한 번의 forward에 필요한 메모리는 줄지 않는다.
는 DP replica 수, 는 accumulation 횟수다. 각 microbatch가 같은 길이와 유효 토큰 수를 갖는다고 가정한다. N0에서 GPU당 2개 시퀀스, DP=8, accumulation 8회라면 한 번의 갱신에 128개 시퀀스를 사용한다. 8개 노드 전체의 DP=64로 확장하면 1,024개다. 길이가 2,048이면 각각 262,144개와 2,097,152개의 입력 위치이며, loss에서 제외한 위치가 있다면 유효 정답 토큰 수는 더 작다.
뒤에서 다룰 tensor parallelism(TP)이나 pipeline parallelism(PP)처럼 같은 모델 계산을 나누는 GPU 수까지 DP 수에 곱하면 batch를 과대 계산한다. Gradient accumulation은 batch를 나누어 처리하는 방법이며, 큰 batch 자체가 항상 더 좋은 학습을 보장하는 것도 아니다.
Optimizer step 하나를 microbatch 두 개로 나누는 과정을 보자. 두 microbatch의 유효 정답 수가 같고 평균 loss가 각각 이면 목표는 다. 다음은 실행 순서를 보여주는 의사코드다.16
gradient를 0으로 초기화
microbatch 1: forward → L₁/2를 backward → gradient 보관
microbatch 2: forward → L₂/2를 backward → 기존 gradient에 더함
필요하면 누적 gradient를 clipping
optimizer.step() 한 번
다음 갱신을 위해 gradient 초기화
두 backward 사이에 가중치는 바꾸지 않는다. 를 나누지 않고 그대로 누적하면 목표 평균 gradient의 두 배가 된다. 유효 정답 수가 각각 2개와 6개라면 평균 loss의 가중치는 가 아니라 이다. 여러 GPU에서도 전역 유효 정답 수와 통신 연산의 합산·평균 규칙을 함께 맞춘다.
각 microbatch의 backward가 끝나면 그 계산 그래프의 activation은 보통 해제할 수 있지만, 누적 gradient는 optimizer step까지 보관한다. 따라서 누적 횟수가 늘어난다고 모든 microbatch의 activation을 동시에 보관할 필요는 없다. Mixed precision에서 loss scaling을 사용한다면 누적 도중 scale을 바꾸지 않고, 최종 clipping과 step 전에 배율을 되돌린다.16
DP에서는 통신 시점도 정해야 한다. Optimizer 갱신을 미룬다고 DDP의 gradient 동기화가 자동으로 미뤄지지는 않는다. 중간 microbatch의 forward와 backward를 no_sync() 안에서 수행하고 마지막 microbatch는 밖에서 수행하면, 마지막 backward에서 누적 gradient를 동기화할 수 있다. Forward까지 같은 context에 포함해야 한다.15
앞의 두 microbatch 예제를 DDP에 적용하면 다음 순서다. 각 GPU·microbatch의 유효 토큰 수가 같고, DDP가 replica 사이에서 gradient를 평균하는 기본 구성을 가정한다.
각 GPU의 gradient 초기화
microbatch 1: no_sync 안에서 forward → L₁/2 backward → 로컬 누적
microbatch 2: forward → L₂/2 backward → 누적 gradient를 DP 그룹에서 동기화
loss scaling을 썼다면 배율 복원 → 전체 누적 gradient clipping
optimizer 갱신 → 다음 갱신을 위해 gradient 초기화
마지막 동기화도 gradient 묶음(bucket)별로 진행될 수 있으므로 통신 호출이 정확히 한 번이라는 뜻은 아니다. 학습률 scheduler를 optimizer update 수 기준으로 설정했다면 microbatch마다 진행하지 않는다. FP16의 overflow로 optimizer 갱신을 건너뛴 경우도 scheduler의 진행 기준과 맞춘다. Token 수 기준 scheduler를 쓰는 설정에서는 실제 누적 학습 토큰 수를 기준으로 관리한다.
3-4. ZeRO와 FSDP
DP에서 모든 GPU가 optimizer 상태를 똑같이 갖고 있어야 할까? 업데이트할 파라미터 구간을 나누면 각 GPU는 자기 구간의 optimizer 상태만 유지할 수 있다. ZeRO는 이 생각을 단계적으로 확장한다.1718
| 방식 | DP 그룹 안에서 나누어 저장하는 것 |
|---|---|
| ZeRO-1 | optimizer state |
| ZeRO-2 | optimizer state + gradient |
| ZeRO-3 | optimizer state + gradient + parameter |
앞의 128 GB 예제에서 FP32 master weight와 두 모멘트 96 GB를 optimizer 쪽 상태로 묶자. N0의 GPU 8개에 나눈 model state의 이상적인 저장량은 다음과 같다.
| 방식 | GPU당 계산 | GPU당 크기 |
|---|---|---|
| 단순 DP | 128 GB | |
| ZeRO-1 | 44 GB | |
| ZeRO-2 | 30 GB | |
| ZeRO-3 | 16 GB |
이것은 상시 저장하는 model state의 단순 모형이다. 실제 peak memory에는 연산 직전에 모으는 parameter, activation, 통신 buffer, allocator 여유 공간 등이 추가된다. ZeRO-3를 사용한다고 16 GB GPU에 반드시 들어간다는 계산은 아니다.
FSDP(fully sharded data parallel)도 학습 상태를 분산 저장한다. PyTorch FSDP2에서는 필요한 parameter를 연산 전에 all-gather로 모으고, backward의 gradient를 reduce-scatter로 합산·분할한다. 메모리를 줄이는 대신 필요한 시점에 통신해야 한다.19
작은 층 하나의 파라미터가 여덟 조각 으로 나뉘어 있다고 하자. N0:G0은 평소 만 저장하지만, 자기 입력 배치로 이 층을 계산할 때는 전체 가 필요하다. Forward 후 다시 분할하는 FSDP 구성을 단순화하면 다음과 같다.19
| 시점 | N0:G0에서 하는 일 | 필요한 통신 |
|---|---|---|
| 층 실행 전 | N0의 여덟 조각을 모아 전체 확보 | All-gather |
| Forward | 전체 로 자기 배치 계산 | 해당 층의 계산 |
| Forward 후 | 임시 전체 가중치를 해제하고 자기 조각 유지 | 다음 실행 준비 |
| 해당 층 backward 전 | 전체 를 다시 확보 | All-gather |
| Backward 후 | 각 replica의 gradient를 합치고 자기 구간만 받음 | Reduce-scatter |
| Optimizer step | 자기 구간의 상태로 갱신 | 다른 GPU도 각자 담당 구간 갱신 |
Gradient의 평균을 맞추는 배율도 적용한다. 다음 forward에서 갱신된 조각들을 다시 모은다. 실제 구현은 여러 층의 통신을 미리 요청하거나 전체 가중치를 더 오래 유지할 수 있다. 따라서 상시 저장량과 계산 중 최대 사용량은 다르며, sharding 단위가 너무 크면 잠깐 모으는 가중치도 커진다.
분할 그룹을 N0의 8개 GPU에서 64개 GPU로 넓히면 이상적인 model state 저장량은 128/64=2 GB까지 내려간다. 대신 층 실행에 필요한 조각을 모으는 통신도 노드 경계를 넘는다. “더 잘게 나누면 메모리는 줄지만, 필요한 값을 더 멀리서 가져올 수 있다”는 선택이다. 2 GB 역시 activation과 임시 buffer를 제외한 값이다.
FSDP와 ZeRO-3는 비슷한 메모리 절감 목표를 갖지만 API(application programming interface)와 저장·통신 단위, 지원 옵션이 같은 구현은 아니다. 실제 선택에서는 사용하려는 모델과 프레임워크의 지원 범위를 확인한다.
세 가지 메모리 기법은 줄이는 대상이 달라 함께 사용할 수 있다.
| 기법 | 메모리를 줄이는 방식 | 함께 고려할 비용 |
|---|---|---|
| Gradient accumulation | 목표 global batch를 유지하면서 microbatch 축소 | 순차 실행 횟수와 gradient 동기화 설정 |
| Activation checkpointing | Microbatch 안에서 보관할 activation을 줄임 | Backward 중 재계산 |
| ZeRO/FSDP | GPU에 중복된 model state를 분할 저장 | Parameter 수집과 gradient 분할 통신 |
FSDP와 checkpointing을 조합하면 재계산 시 parameter를 다시 모으는 통신이 추가될 수도 있다. Gradient 동기화를 미루면 gradient 저장 방식에 따라 메모리가 늘 수도 있으므로, DDP의 no_sync() 동작을 다른 분산 구현에 그대로 가정하지 않는다. 조합한 실행에서 peak memory와 처리량을 측정한다.
보충: CPU·NVMe offload
GPU 밖의 메모리를 사용하는 선택도 있다. Offload는 optimizer 상태나 parameter 등을 CPU 메모리 또는 NVMe(non-volatile memory express) 저장장치로 옮겨 GPU의 상주 메모리를 줄인다. 예를 들어 ZeRO-Offload는 optimizer 상태와 갱신 계산을 CPU 쪽으로 옮길 수 있다.20
GPU끼리 나누는 sharding과 달리 저장 위치 자체를 바꾸며, 데이터 전송과 CPU 연산 또는 저장장치 접근 비용이 생긴다. “GPU에 들어가는가”를 해결해도 “충분히 빠른가”는 별도 문제다. CPU 메모리와 NVMe의 용량·대역폭도 함께 확인한다. Parameter까지 NVMe로 내리는 ZeRO-Infinity 같은 구성은 더 큰 모델을 지원하기 위한 선택지다.21
4. 모델·시퀀스 분산
4-1. TP
TP(tensor parallelism)는 하나의 층 안에서 큰 행렬 연산을 나눈다. Megatron-LM은 Transformer의 attention과 FFN(feed-forward network)에 이 방식을 적용한다.22
N0의 G0–G7이 같은 층의 계산을 나누는 TP=8을 생각하자. 계산식을 작게 보기 위해 먼저 G0·G1만 사용하는 TP=2 예를 들자. 두 선형층과 원소별 활성함수 를 연결한 작은 FFN을 사용한다. Bias는 생략한다.
입력 는 , 첫 가중치 는 , 두 번째 가중치 는 다. 먼저 를 열 방향으로 두 조각 에 나눈다. 각 GPU는 같은 와 자기 조각으로 중간값을 계산한다.
| GPU | 첫 가중치 조각 | 로컬 중간값 | 중간값의 크기 |
|---|---|---|---|
| N0:G0 | : | ||
| N0:G1 | : |
여기서 전체 를 모으지 않고 다음 층으로 갈 수 있다. 를 행 방향으로 씩 나누면 각 GPU는 자기 와 가중치 조각 만으로 부분 결과를 만든다.
두 부분 결과는 모두 다. 이번에는 옆으로 이어 붙이는 것이 아니라 같은 위치끼리 더해야 전체 가 된다. 기본 TP 구성에서는 all-reduce로 합산해 두 GPU가 결과를 받는다. 예를 들어 G0의 첫 출력 성분 기여가 5, G1의 기여가 7이면 전체 출력의 그 성분은 12다.2223
같은 X ── G0: A₀ → H₀ → B₀ → 부분 결과 ──┐
       └─ G1: A₁ → H₁ → B₁ → 부분 결과 ──┴─ all-reduce 합산 → Y
                중간 H 전체를 모을 필요 없음
Backward에서도 입력 gradient에 대한 각 조각의 기여를 합치는 통신이 필요하다. 통신 위치는 층의 분할과 다음 연산이 요구하는 배치에 따라 정해진다. SP를 함께 쓰면 전체 결과를 복제하는 대신 reduce-scatter로 나누어 받는 부분도 생긴다.
FSDP와의 차이는 연산할 때도 나누어 계산하는가에 있다. 앞의 FSDP 예에서는 parameter 조각을 모아 각 GPU가 자기 배치에 대해 해당 층을 계산했다. 여기서는 같은 배치에 대해 각 GPU가 층의 일부 연산만 수행하고 부분 결과를 합친다. 저장된 가중치가 나뉘어 있다는 사실만으로 두 방식을 같은 것으로 볼 수는 없다.
TP는 행렬 연산의 규모를 나누지만 층마다 필요한 통신이 생긴다. 같은 batch를 사용하므로 TP 장치를 두 배 늘린다고 서로 다른 학습 샘플을 두 배 읽는 것은 아니다. 빠른 장치 간 연결이 중요한 이유다. TP=8에서는 같은 원리로 행렬을 여덟 조각으로 나누며, 이 예제는 그 그룹을 N0 안에 둔다. N1–N7에도 같은 8 GPU 모델을 배치하면 TP=8인 모델 복제본이 8개가 된다. 노드 내부에서는 같은 입력의 행렬 계산을 나누고, 노드 사이에서는 대응하는 파라미터 조각의 gradient를 동기화한다. 이때 DP=8이지 64가 아니다.
4-2. PP
PP(pipeline parallelism)는 층을 여러 stage로 나눈다. 32층 모델을 두 stage로 나누면 앞 stage가 1–16층, 뒤 stage가 17–32층을 맡는다. 여기서는 N0의 GPU 8개가 TP=8로 앞 stage를, N1의 GPU 8개가 TP=8로 뒤 stage를 계산한다고 하자. 두 노드가 모델 하나를 담당하는 TP=8, PP=2 구성이다. 앞 stage의 출력 activation은 뒤 stage의 입력이 되고, backward에서는 gradient가 반대 방향으로 이동한다.24
배치 하나만 넣으면 N1의 stage는 N0의 출력을 기다린다. 여러 microbatch를 흘려보내면 일부 작업을 겹칠 수 있다. 아래는 forward만 그린 교육용 시간표이며, 각 stage의 실행 시간이 같다고 가정한다.
| 시간 | N0의 GPU 8개: 앞 절반 | N1의 GPU 8개: 뒤 절반 |
|---|---|---|
| 1 | microbatch A | 대기 |
| 2 | microbatch B | microbatch A |
| 3 | microbatch C | microbatch B |
| 4 | 대기 | microbatch C |
처음과 마지막의 빈 구간이 pipeline bubble이다. 실제 학습에서는 backward를 언제 배치하는지, activation을 얼마나 보관하는지까지 scheduling해야 한다. Stage마다 층 수가 같아도 embedding·출력 head 등의 비용으로 실행 시간이 다를 수 있다.
N0에서 A의 forward가 끝나도 A의 backward는 마지막까지 기다린다. 그 사이에는 backward에 필요한 값을 보관하거나, §2-3의 activation checkpointing으로 복원할 수 있도록 해야 한다. Microbatch를 더 많이 흘리면 bubble의 상대적 비중을 줄일 수 있지만, 이 시간표에서는 먼저 처리한 microbatch의 activation을 더 오래 유지한다. A·B·C의 gradient를 누적하고 모든 backward가 끝난 뒤 가중치를 한 번 갱신하므로 §3-3의 gradient accumulation과도 연결된다.24
1F1B(one forward, one backward)는 초기 준비 구간 이후 forward와 backward를 번갈아 배치하는 스케줄이다. 먼저 들어온 microbatch의 backward를 일찍 끝내면 그 activation을 해제할 수 있다. 모든 forward를 먼저 수행하는 방식보다 동시에 살아 있는 activation을 줄일 수 있지만, 기본 1F1B에도 pipeline을 채우고 비우는 bubble은 남는다. 여기서는 모든 microbatch의 backward 후 한 번 갱신하는 동기식 스케줄을 기준으로 한다.23
예제: 같은 세 microbatch를 1F1B로 처리하기
앞 그림처럼 forward와 backward를 각각 한 칸으로 놓고 통신 시간은 생략한다. F는 forward, B는 backward이며 괄호 안의 A·B·C는 microbatch 이름이다.
| 시간 | N0: 앞 stage | N1: 뒤 stage | 칸이 끝난 뒤 N0에서 backward를 기다리는 microbatch |
|---|---|---|---|
| 1 | F(A) | 대기 | A |
| 2 | F(B) | F(A) | A, B |
| 3 | 대기 | B(A) | A, B |
| 4 | B(A) | F(B) | B |
| 5 | F(C) | B(B) | B, C |
| 6 | B(B) | F(C) | C |
| 7 | 대기 | B(C) | C |
| 8 | B(C) | 대기 | 없음 |
앞 그림과 총 시간은 8칸으로 같다. 하지만 N0에서 forward 후 backward를 기다리는 microbatch는 최대 3개에서 2개로 줄고, A의 activation도 4칸째에 해제할 수 있다. 이 예제에서 달라진 것은 저장 기간과 동시 보관량이다. 실제 효과는 stage 수, microbatch 수, 재계산 범위와 forward/backward 실행 시간에 따라 달라진다.
이 배치에서 층 내부의 TP 통신은 노드 안에 있고, stage 경계의 activation과 그 gradient는 노드 사이로 이동한다. PP도 microbatch마다 경계 통신이 필요하므로 노드 간 통신 비용이 사라지는 것은 아니다. N2·N3, N4·N5, N6·N7에도 같은 두 노드 묶음을 만들면 모델 복제본은 4개, 즉 DP=4가 된다.
따라서 PP에서는 “나누었는가?”와 함께 stage 사이의 작업량이 균형적인가?를 확인한다.
4-3. SP와 CP
SP·CP는 시퀀스 방향의 계산이나 저장을 여러 장치에 나누는 방법이다. 모델 가중치를 나누어도 시퀀스가 길어지면 activation이 커진다. 이때 시퀀스 방향으로 나누는 방법이 필요하다. 문헌과 구현마다 용어가 다를 수 있으므로 여기서는 Megatron의 구분을 따른다.25
SP(sequence parallelism)는 TP와 함께 사용해, LayerNorm 같은 일부 연산에서 TP 장치마다 중복되던 activation을 시퀀스 방향으로 분할한다. 예를 들어 N0의 TP=8 그룹에서 길이 8,192인 activation을 GPU마다 길이 1,024씩 보유하게 하는 식이다. 다음 TP 연산에 맞춰 조각을 모으는 all-gather나 결과를 합산·분할하는 reduce-scatter 등을 사용한다. §4-1의 TP에서 중간 결과를 어떻게 배치할지도 함께 바꾸어, 중복 activation을 줄이는 것이다.6
CP(context parallelism)는 입력 시퀀스를 나누어 attention을 포함한 층 전반에서 처리한다. 예를 들어 N0와 N1이 각각 앞 4,096토큰과 뒤 4,096토큰을 맡고, 노드 내부에서는 TP=8을 사용한다고 하자. 이는 TP=8, CP=2의 16 GPU 묶음이다. 뒤쪽 query는 causal mask상 앞쪽 key/value도 참조해야 하므로 장치 사이에 필요한 정보를 전달해야 한다.25
N0의 TP 그룹: 위치 0–4095의 query 처리
N1의 TP 그룹: 위치 4096–8191의 query 처리
               ← N0가 맡은 앞 위치의 key/value도 필요
주의
긴 문서를 두 조각으로 자르고 서로 통신하지 않으면, 뒤 조각은 앞 문맥을 읽을 수 없다. 그것은 원래의 긴 context attention과 다른 계산이다. CP는 필요한 문맥을 교환하면서 작업을 나누는 방법이다.
위의 앞·뒤 절반 배치는 통신 필요성을 보여주는 단순한 예다. Causal attention에서는 뒤쪽 query가 더 많은 이전 위치를 참조하므로 길이가 같아도 유효 attention 계산량이 다르다. Megatron은 이를 균형 있게 배치하기 위해 시퀀스를 더 작은 조각으로 나누어 앞·뒤 조각을 짝지을 수 있다. 길이 8,192를 네 조각으로 나눈 CP=2 예는 다음과 같다.26
| TP 그룹 | 담당 query 위치 |
|---|---|
| N0 | 0–2047과 6144–8191 |
| N1 | 2048–4095와 4096–6143 |
각 그룹은 여전히 4,096개의 query를 계산하지만, 참조 범위가 작은 앞쪽과 큰 뒤쪽을 나누어 맡는다. 이 배치에서도 다른 조각의 key/value를 교환해야 한다. 또한 같은 가중치에 대한 gradient는 시퀀스 조각별 기여를 모아야 한다. CP=2는 독립 문서 두 개를 읽는 DP=2와 다르다.27
4-4. EP
MoE(mixture of experts)는 여러 expert 중 토큰별로 일부를 선택해 계산하는 구조다. EP(expert parallelism)는 이 expert들을 여러 장치에 나누어 배치한다.28
예를 들어 N0:G0에 expert 0, N0:G1에 expert 1을 배치했다고 하자. Router가 G0의 어떤 토큰을 expert 1로 보내기로 했다면 activation을 같은 노드의 G1로 전달한다. Expert 1을 N1:G0에 배치하면 같은 routing이 노드 간 통신이 된다. 계산이 끝나면 출력도 원래 토큰 순서에 맞게 돌려놓는다.
여러 장치가 서로 다른 토큰 묶음을 주고받는 all-to-all 통신과 expert별 부하 균형(load balancing)이 중요해진다. 많은 토큰이 하나의 expert에 몰리면 다른 장치가 기다릴 수 있다. 이번 주에는 이 분산 문제까지만 이해하고, router·expert 구조와 학습 방법은 다음 주에 다룬다.
5. 분산 학습 구성
5-1. 6D Parallelism과 병렬화 조합
앞에서 살펴본 병렬화 방법을 여섯 방향으로 묶어 보자. 이 절에서는 DP·TP·PP·SP·CP·EP를 함께 살펴보는 관점을 6D(six-dimensional) Parallelism으로 정리한다. SP와 CP는 §4-3에서 설명한 Megatron의 구분을 따른다.25
| 축 | 나누는 대상 |
|---|---|
| DP | 서로 다른 입력 데이터 |
| TP | 층 내부의 행렬 계산 |
| PP | 모델의 층 |
| SP | 일부 연산의 시퀀스 방향 activation |
| CP | 긴 문맥의 시퀀스 위치 |
| EP | MoE의 expert |
여섯 방향은 모두 독립적인 GPU 개수의 곱이 되는 것은 아니다. Megatron의 SP는 TP 그룹과 함께 사용하고, EP는 MoE의 expert를 분산할 때 사용한다. 모델과 입력에 맞는 조합을 선택하자.25
처음의 8개 노드에 두 가지 구성을 대입하자. 두 그림에서 노드의 물리적 위치는 같고, 같은 모델을 계산하는 묶음과 통신 상대가 달라진다.
논문의 일반적인 결합 도식은 서베이 Figure 8에서 비교할 수 있다. 그 그림의 Sequence Parallel은 §4-3의 Megatron SP와 범위가 다르므로, 여기서는 본문의 DP·TP·PP 그룹을 기준으로 읽는다.
구성 A: TP=8, DP=8. 노드 하나의 GPU 8개가 모델의 모든 층을 함께 계산한다. 각 노드가 서로 다른 배치를 읽으므로 복제본은 8개다. N0:G0, N1:G0, …, N7:G0은 같은 파라미터 조각을 맡는 DP 그룹이다. 같은 방식으로 G1–G7에도 각각 DP 그룹이 있다.
구성 B: TP=8, PP=4, DP=2. 32층 모델을 네 stage로 나누고, stage마다 노드 하나를 배정한다. 층 수를 똑같이 나눈 것은 교육용이며 실제로는 실행 시간을 보고 조절한다.
| stage | 담당 층 | 복제본 0: 배치 A | 복제본 1: 배치 B |
|---|---|---|---|
| 0 | 1–8 | N0:G0–G7 | N4:G0–G7 |
| 1 | 9–16 | N1:G0–G7 | N5:G0–G7 |
| 2 | 17–24 | N2:G0–G7 | N6:G0–G7 |
| 3 | 25–32 | N3:G0–G7 | N7:G0–G7 |
표의 한 열에서 N0→N1→N2→N3으로 activation이 흐르고, backward의 gradient는 반대로 흐른다. 각 노드 안의 G0–G7은 TP 통신을 한다. 같은 행의 N0:G0과 N4:G0은 같은 층의 같은 파라미터 조각을 맡으므로 DP gradient를 동기화한다. N1과 N5, N2와 N6, N3과 N7에도 같은 관계가 있다. PP 통신과 DP 통신 모두 노드 경계를 넘지만 전달하는 값과 참여하는 상대가 다르다.
| 같은 64 GPU의 사용법 | 구성 A | 구성 B |
|---|---|---|
| 모델 하나를 담당하는 노드 | 1개 | 4개 |
| 서로 다른 데이터를 읽는 복제본 | 8개 | 2개 |
| 노드 내부 통신 | TP | TP |
| 노드 간 통신 | DP gradient 동기화 | stage 경계 전달 + DP gradient 동기화 |
Microbatch가 모델 복제본당 2개 시퀀스이고 accumulation이 8회라면 global batch는 A에서 , B에서 다. 같은 global batch 128로 비교하려면 B의 accumulation을 32회로 바꾸는 등의 조정이 필요하다. GPU 수만 같다고 학습 조건까지 같은 것은 아니다.
CP까지 사용하면 이 예제의 장치 수 계산에 CP 차원도 포함한다. SP는 별도 독립 장치 수를 곱하는 항이 아니다. EP의 그룹 구성은 프레임워크와 MoE 설정을 함께 봐야 하므로 여섯 값을 무조건 곱하지 않는다.
두 구성의 모양만 보고 더 빠른 쪽을 고를 수는 없다. 먼저 model state와 activation이 들어가는 구성을 찾고, 같은 학습 조건에서 microbatch 크기와 병렬화 비율을 조정한다. 예를 들어 TP를 늘려 메모리를 확보해도, 각 GPU의 행렬곱이 너무 작아지거나 통신이 늘어 처리량이 내려갈 수 있다.23
5-2. Sequence packing
GPU에 모델이 들어가더라도, 계산하는 입력의 상당 부분이 빈칸이라면 자원을 낭비할 수 있다. 길이 8의 입력 배열을 사용하는 단순한 예제를 보자. 문서 A의 입력 길이는 3, B는 4다. 각각을 길이 8에 맞추면 남는 위치를 padding으로 채운다.
아래 A0·A1·A2는 A의 입력 토큰 위치, B0–B3는 B의 입력 토큰 위치다. ·는 padding이며 실제 학습 텍스트가 아니다.
| 구성 | 길이 8의 입력 배열 | 유효 입력 위치 |
|---|---|---|
| 개별 padding: A | A0 A1 A2 · · · · · | 3 / 8 |
| 개별 padding: B | B0 B1 B2 B3 · · · · | 4 / 8 |
| Sequence packing: A+B | A0 A1 A2 B0 B1 B2 B3 · | 7 / 8 |
개별 padding은 총 16칸 중 7칸(43.75%)이 유효하고, packing은 8칸 중 7칸(87.5%)이 유효하다. Sequence packing은 여러 짧은 시퀀스를 하나의 배열에 함께 담아 padding을 줄이는 방법이다. 단순한 dense 연산에서는 loss에서 padding을 무시해도 입력 배열의 빈 위치에 대한 연산이 남을 수 있어, 빈칸 자체를 줄이는 것이 중요하다.29
함께 담는다고 두 문서가 한 문맥이 되어야 하는 것은 아니다. 독립 문서를 유지하려면 A는 A 안에서만, B는 B 안에서만 이전 위치를 참조하게 한다. 예를 들어 B0는 앞에 저장된 A0–A2를 보지 못하고, B2는 B0·B1·B2만 본다. 실제 구현은 시퀀스 경계 정보를 attention 연산에 전달한다. 입력을 단순히 이어 붙이는 것만으로 이 조건이 충족되지는 않는다.
정답도 Pre-training의 문서별 입력·정답 예제처럼 각 문서에 맞춘 값을 유지한다. 입력 배열을 채운 정도가 두 배가 되었다고 학습 속도가 반드시 두 배가 되는 것은 아니다. Attention 구현, 배열 구성 비용, batch 설정에 따라 실제 이득이 달라진다. 같은 학습 목표와 유효 토큰 수를 기준으로 처리량을 비교해야 한다.
이 예제는 padding이 많이 생기는 조건을 가정했다. Batch 안의 최대 길이까지만 채우거나 비슷한 길이를 묶는 방법도 padding을 줄일 수 있다. 이미 문서들을 이어서 고정 길이를 채우는 pre-training은 같은 낭비가 작을 수 있다. Megatron Bridge의 packed-sequence 기능은 주로 길이가 다양한 fine-tuning 예제를 위한 것으로 설명된다. 따라서 이름만 보고 모든 pre-training에 켜야 하는 옵션으로 받아들이지 않는다.29
6. 성능 측정과 학습 운영
6-1. 비교 조건과 처리량
메모리에 들어가는 구성을 찾았으면 같은 학습 작업을 얼마나 빨리 처리하는지 비교한다. 모델·데이터·시퀀스 길이·global batch·정밀도·loss 정규화를 기록한다. Microbatch 실행 시간과 optimizer step 시간은 다르다. Accumulation을 바꾸어 비교할 때는 한 번의 갱신에 필요한 모든 microbatch를 포함한다.
이 노트의 유효 tokens/s는 전체 DP replica에서 loss에 기여한 정답 토큰 수를 중복 없이 합한 값 / 경과 시간으로 정한다. TP·PP에 같은 입력이 전달되었다고 다시 세지 않는다. CP로 나눈 위치도 원래 시퀀스에서 한 번씩 센다. Padding이나 loss mask가 바뀌면 입력 배열의 칸 수만으로 비교하지 않는다.
다음은 설정 비교를 위한 가상 측정값이며 특정 모델·장비의 성능 수치가 아니다. DP=8, 시퀀스 길이 2,048이고 모든 위치가 loss에 기여한다고 단순화했다. 모델과 장치 배치는 같고, global batch는 128개 시퀀스, 즉 갱신당 262,144토큰으로 맞췄다.
| 설정 | Microbatch × 누적 | 재계산 | Peak memory | 갱신 시간 | 유효 tokens/s |
|---|---|---|---|---|---|
| A | 2 × 8 | 끔 | 70 GB | 2.0 s | 131,072 |
| B | 1 × 16 | 끔 | 56 GB | 2.5 s | 104,858 |
| C | 2 × 8 | 켬 | 49 GB | 2.3 s | 113,976 |
| D | 4 × 4 | 켬 | 68 GB | 1.8 s | 145,636 |
표의 peak memory는 GPU별 최댓값 중 가장 큰 값이고, 처리량은 전체 장치 기준으로 반올림했다. B는 작은 microbatch로 메모리를 줄였지만 더 느리다. C도 재계산 때문에 A보다 느리지만, D에서는 확보한 공간으로 microbatch를 키워 처리량이 높아졌다. 실제로 이런 결과가 나올지는 측정해야 한다. 이 예제의 목적은 메모리 절감 옵션 하나의 속도만 보지 않고, 그 옵션으로 가능한 batch 구성까지 비교하는 것이다.
GPU 수 에서 처리량을 라고 하면 scaling efficiency를 로 살펴볼 수 있다. 단, 한 GPU에서도 같은 모델이 실행되어야 이 기준이 의미가 있다. 그렇지 않으면 실행 가능한 최소 장치 수를 기준으로 비교한다. 모델·시퀀스 길이·정밀도 등 비교 조건을 함께 기록한다.
실행 가능한 최소 구성이 노드 하나의 GPU 8개라면 기준을 다음처럼 바꾼다.
예를 들어 노드 하나(8 GPUs)에서 10,000 tokens/s, 두 노드(16 GPUs)에서 17,000 tokens/s라면 처리량은 1.7배이고 효율은 85%다. 총 개 유효 토큰을 읽는 순수 학습 시간은 각각 약 27.8시간과 16.3시간이다. 반면 GPU 사용 시간의 합은 약 222.2 GPU-hours와 261.4 GPU-hours로 늘어난다. 빠른 완료와 적은 자원 소비는 서로 다른 비교다. 수치는 교육용이며 평가·저장·장애 시간은 제외했다.
6-2. 병목 진단
Profiling은 연산·통신·데이터 대기의 시간을 나누어 관찰하는 과정이다. 처음 몇 step에는 초기화 등의 비용이 섞이므로 준비 실행 후 여러 optimizer step을 측정한다. 여기서 준비 실행은 학습률 warmup과 다른 의미다. GPU 연산은 비동기이므로 CPU에서 호출에 걸린 시간만 재면 실제 GPU 실행 시간과 다를 수 있다. GPU event나 동기화 경계를 사용하고, 모든 장치가 마친 시점까지 포함해 측정한다.30
PyTorch Profiler는 CPU·GPU의 연산 시간과 메모리 사용, 실행 시간표를 확인할 수 있다. 데이터 읽기, forward, backward, optimizer 갱신 구간을 표시해 어느 단계에 대기가 생기는지 본다. Profiler 자체도 실행 비용을 더하므로 병목을 찾은 뒤 처리량 비교는 profiling을 끈 실행에서도 확인한다.31
예를 들어 준비 실행 이후 100개 optimizer step에서, 매 step 시작에 GPU가 오래 쉬고 그 시간에 CPU가 다음 batch를 준비한다고 하자. 메모리에 여유가 있어도 이것만으로 GPU 계산이 빨라지지는 않는다. 입력 읽기·전처리·전송 중 어디서 지연되는지 확인하고, 미리 데이터를 준비하는 prefetch나 데이터 로더의 worker 구성을 조정한 뒤 같은 구간을 다시 측정한다.
| 관찰한 현상 | 먼저 구분할 원인 | 검토할 변경 |
|---|---|---|
| Activation이 쌓이기 전부터 용량이 부족함 | Parameter·gradient·optimizer 상태의 크기 | ZeRO/FSDP, TP·PP, 필요하면 offload |
| 시퀀스나 microbatch를 키우면 forward/backward 중 용량 초과 | Activation과 attention 중간값, 임시 buffer | Microbatch 축소+누적, checkpointing, FlashAttention, SP·CP |
| 특정 층을 모으거나 계산할 때만 메모리가 급증함 | FSDP 수집 단위 또는 큰 층의 작업 공간 | Sharding 단위 조정, TP, 실행 중 메모리 추적 |
| 다음 batch 전에 GPU가 반복해서 쉼 | 저장장치 읽기·전처리·CPU→GPU 전송 | 데이터 공급 파이프라인과 prefetch 조정 |
| GPU 수를 늘렸는데 통신 대기 비중이 커짐 | 통신량·빈도·노드 간 경로와 겹치기 여부 | DP 누적 동기화 시점, TP·PP 배치, 통신 묶음 조정 |
| 특정 stage나 expert만 계속 바쁨 | 층별 실행 시간 또는 routing 불균형 | PP stage 재배치, MoE 부하 균형 |
통신도 계산과 겹칠 수 있다. DDP는 준비된 gradient를 bucket 단위로 전달하면서 다른 층의 backward를 계속 수행할 수 있고, FSDP는 다음에 필요한 가중치 통신을 미리 요청할 수 있다. 다만 해당 값을 기다리는 계산은 먼저 진행할 수 없다. 따라서 profiler의 통신 시간 총합을 모두 step의 추가 시간으로 더하지 않고, 계산과 겹치지 못한 대기 구간을 본다.1519
6-3. 장애 복구와 재현
빠른 한 step만으로 며칠짜리 학습의 완료 시간을 설명할 수는 없다. 평가, checkpoint 저장, 장치 장애와 재시작도 전체 시간에 포함된다. 여기서 checkpoint는 §2-3의 activation 재계산용 중간값이 아니라 학습을 재개하기 위해 저장한 상태다.1
| 저장·기록할 항목 | 복구에서 필요한 이유 |
|---|---|
| Model parameter와 optimizer 상태 | 가중치와 누적된 갱신 통계를 이어감 |
| Scheduler 상태, update 수와 학습 토큰 수 | 학습 진행도와 learning rate를 맞춤 |
| Loss scaler 상태(사용 시) | Mixed precision의 scale 상태를 이어감 |
| 난수 상태와 데이터 진행 위치 | Dropout·샘플 순서·읽은 구간을 복원 |
| 모델·tokenizer·데이터·실행 설정과 버전 | 같은 실행 조건을 재구성 |
가중치만 불러오는 것과 학습 상태를 복구하는 것은 다르다. PyTorch의 일반 checkpoint 예제도 model뿐 아니라 optimizer 상태를 함께 저장한다.32 분산 학습에서는 각 장치의 조각이 하나의 일관된 저장 시점에 속하는지, 장치 수를 바꿔 복구할 수 있는지도 구현에 따라 확인한다.
장시간 실행에 앞서 짧게 학습한 뒤 저장·종료·복구해 본다. 이어지는 learning rate, update 수, 데이터 위치와 loss가 예상대로 연결되는지 확인한다. 저장은 optimizer 갱신 경계에서 수행하면 미완료 accumulation을 복원하는 부담을 줄일 수 있다. 파일 기록이 완료된 checkpoint만 복구 대상으로 사용한다. 환경이나 병렬화 구성이 달라지면 부동소수점 계산 순서도 달라질 수 있으므로 bit 단위 일치까지 자동으로 보장되지는 않는다.
6-4. 도구와 recipe
| 도구·프로젝트 | 읽을 때 확인할 역할 |
|---|---|
| PyTorch DDP | 모델 복제와 gradient 동기화 |
| PyTorch FSDP2 | PyTorch 모델의 학습 상태 sharding |
| DeepSpeed | ZeRO 및 분산 학습·메모리 최적화 기능 |
| Megatron Core / Megatron Bridge | Transformer 병렬화와 학습 설정·모델 연결 |
| NVIDIA NeMo | 대규모 모델 학습·사용자화의 프레임워크 생태계 |
| Nemotron | 모델·데이터·공개 training recipe를 읽을 실제 사례 |
FSDP2의 예제는 공식 튜토리얼, ZeRO 단계별 설정은 DeepSpeed 문서, 병렬화 조합은 Megatron Bridge 가이드에서 확인한다.191825 API는 버전에 따라 바뀌므로 설정 파일을 옮길 때 문서 버전과 설치 버전을 맞춘다.
Nemotron의 공개 training recipe는 모델 구성·데이터·학습 단계가 실제 실행 설정으로 연결되는 사례다.33 Recipe를 읽을 때에는 모델 크기와 시퀀스 길이에서 출발해, parameter·gradient의 정밀도, TP·PP·DP·CP 구성, microbatch와 global batch, 재계산 범위, 저장·복구 설정을 차례로 대응시킨다. 공개 recipe의 데이터와 전체 공개 모델을 학습한 데이터가 완전히 같은지도 별도로 확인한다.
심화: 정밀도·스케줄 최적화
Footnotes
-
Duan, J., et al. (2024). Efficient Training of Large Language Models on Distributed Infrastructures: A Survey. arXiv:2407.20018v1. ↩ ↩2 ↩3 ↩4 ↩5
-
Wang, S., & Kanwar, P. (2019). BFloat16: The secret to high performance on Cloud TPUs. Google Cloud Blog. ↩
-
Kalamkar, D., et al. (2019). A Study of BFLOAT16 for Deep Learning Training. arXiv:1905.12322. ↩
-
Micikevicius, P., et al. (2018). Mixed Precision Training. ICLR 2018. arXiv:1710.03740. ↩
-
PyTorch. (2025, v2.8). Automatic Mixed Precision. ↩
-
Korthikanti, V. A., et al. (2023). Reducing Activation Recomputation in Large Transformer Models. MLSys 2023. arXiv:2205.05198. ↩ ↩2
-
Chen, T., Xu, B., Zhang, C., & Guestrin, C. (2016). Training Deep Nets with Sublinear Memory Cost. arXiv:1604.06174. ↩
-
Hugging Face. (v5.7.0). Gradient checkpointing. Transformers 공식 문서. ↩
-
Dao, T., Fu, D. Y., Ermon, S., Rudra, A., & Ré, C. (2022). FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS 2022. arXiv:2205.14135. ↩ ↩2 ↩3
-
Dao, T. (2023). FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning. arXiv:2307.08691. ↩
-
Shah, J., Bikshandi, G., Zhang, Y., Thakkar, V., Ramani, P., & Dao, T. (2024). FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision. arXiv:2407.08608. ↩
-
Dao, T. (2026). FlashAttention-4: Algorithm and Kernel Pipelining Co-Design for Asymmetric Hardware Scaling. 저자 해설. ↩
-
Wen, W. (2026). Introduction to torch.compile. PyTorch 공식 튜토리얼. ↩
-
PyTorch Contributors. (v2.8). DistributedDataParallel. 공식 문서. ↩ ↩2 ↩3 ↩4
-
PyTorch Contributors. (2025, v2.8). Automatic Mixed Precision examples. 공식 문서. ↩ ↩2
-
Rajbhandari, S., Rasley, J., Ruwase, O., & He, Y. (2020). ZeRO: Memory Optimizations Toward Training Trillion Parameter Models. SC 2020. arXiv:1910.02054. ↩
-
Feng, W., Constable, W., & Mao, Y. (2025). Getting Started with Fully Sharded Data Parallel (FSDP2). PyTorch 공식 튜토리얼. ↩ ↩2 ↩3 ↩4
-
Rajbhandari, S., Ruwase, O., Rasley, J., Smith, S., & He, Y. (2021). ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning. SC 2021. arXiv:2104.07857. ↩
-
Shoeybi, M., et al. (2019). Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism. arXiv:1909.08053. ↩ ↩2
-
Narayanan, D., et al. (2021). Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM. SC 2021. arXiv:2104.04473. ↩ ↩2 ↩3 ↩4
-
Huang, Y., et al. (2019). GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism. NeurIPS 2019. arXiv:1811.06965. ↩ ↩2
-
NVIDIA. Parallelisms Guide. Megatron Bridge 공식 문서. ↩ ↩2 ↩3 ↩4 ↩5
-
NVIDIA. core.utils. Megatron Core 공식 문서. ↩
-
NVIDIA. Context Parallel Package. Megatron Core 공식 문서. ↩
-
Fedus, W., Zoph, B., & Shazeer, N. (2022). Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. Journal of Machine Learning Research, 23(120), pp. 1–39. arXiv:2101.03961. ↩
-
NVIDIA. Packed Sequences. Megatron Bridge 공식 문서. ↩ ↩2
-
Raikundalia, S. (2026). PyTorch Profiler. PyTorch 공식 튜토리얼. ↩
-
Inkawhich, M. (2025). Saving and Loading Models. PyTorch 공식 튜토리얼. ↩
-
NVIDIA. Nemotron Training Recipes. 공식 문서, Stage 0: Pretraining. ↩