Week 2
Scaling
같은 계산 예산이라면, 모델을 더 크게 만드는 게 좋을까, 더 많은 토큰으로 학습하는 게 좋을까? 학습을 시작하기 전에 어느 쪽의 성능이 더 좋을지 예측할 수 있을까? 먼저 모델 크기와 학습 토큰 수에 따라 loss가 어떻게 달라지는지 살펴보고, 이 관계를 이용해 주어진 계산 예산 안에서 두 자원을 배분하는 방법을 알아본다.1
1. Scaling laws
Scaling law는 규모와 성능 사이에서 관찰되는 규칙적인 관계를 수식으로 표현한다. 이 노트에서는 모델 크기 과 학습 토큰 수 로 loss를 예측하는 모형을 살펴본다. 두 값을 선택하면 필요한 계산량 도 대략 정해지므로, 계산 예산은 선택 가능한 조합을 제한한다. 성능은 먼저 평가 데이터의 평균 next-token prediction loss로 측정한다. Loss가 얼마나 줄어드는지와, 질의응답·추론 같은 개별 과제(downstream task)의 점수가 얼마나 오르는지는 구분해서 살펴봐야 한다.
작은 실험에서 얻은 관계가 더 큰 실험에서도 맞는다면, 아직 실행하지 않은 규모의 성능을 예측할 근거가 생긴다. 여기서 law는 주어진 실험 조건에서 관찰하고 맞춘 경험적 관계다. 규모를 무한히 키우면 성능도 계속 좋아진다는 보장이나, 데이터 분포와 모델 구조가 바뀌어도 같은 계수가 유지된다는 자연법칙은 아니다.
1-1. 모델·데이터·계산량
| 기호 | 뜻 |
|---|---|
| 모델의 파라미터 수 | |
| 학습에 소비한 토큰 수 | |
| 학습에 사용한 총 계산량 | |
| 평가 데이터에서 계산한 평균 next-token prediction loss |
는 고유한 텍스트 양과 같지 않을 수 있다. 같은 데이터를 반복해서 읽어도 소비한 토큰 수는 늘어난다. 또한 tokenizer가 바뀌면 같은 문서의 토큰 수가 달라지므로 서로 다른 실험의 를 해석할 때 조건을 확인해야 한다.
는 학습 중 수행하는 부동소수점 연산을 세어 나타낸다. 이 연산 횟수를 FLOPs(floating-point operations)라고 하며, 곱셈 한 번과 덧셈 한 번을 수행하면 2 FLOPs로 센다.
를 비교할 때는 tokenizer·평가 텍스트를 맞춘다.
학습 연산의 기본 단위인 선형층을 보자. 입력 에 가중치 를 곱해 출력 를 만든다. Forward에서는 출력을 계산하고, backward에서는 입력과 가중치에 대한 gradient를 계산한다.
Dense Transformer의 학습 FLOPs를 대략적으로 추산할 때, Kaplan et al. (2020)은 embedding을 제외한 파라미터 수를 으로 두고 forward 비용을 토큰당 약 , backward 비용을 그 두 배인 약 으로 잡는다. 따라서 학습에 소비한 토큰 수가 이면 총계산량은 다음과 같다.2
Forward 연산량 상세: Kaplan et al. (2020), Table 1
아래는 Kaplan et al. (2020)의 Table 1에 제시된 파라미터 수와 forward의 토큰당 FLOPs다. 층 수를 , 문맥 길이를 , 어휘 크기를 으로 쓴다. 은 모델의 은닉 차원, 은 여러 head를 합친 attention 출력 차원, 는 feedforward 중간 차원이다.2
| Operation | Parameters | FLOPs per Token |
|---|---|---|
| Embed | ||
| Attention: QKV | ||
| Attention: Mask | — | |
| Attention: Project | ||
| Feedforward | ||
| De-embed | — | |
| Total (Non-Embedding) |
출처: Kaplan et al. (2020), Scaling Laws for Neural Language Models, Table 1.
표는 비선형 함수·bias·layer normalization 등의 작은 항을 생략한 근사다. 마지막 행은 embedding 관련 연산을 제외한 합계이며, 문맥 길이에 따른 두 번째 항이 상대적으로 작을 때 forward 비용을 약 으로 본다.
이 식은 주요 행렬곱(곱셈과 덧셈)을 중심으로 한 근사로, 긴 시퀀스의 attention 비용이나 embedding, activation 등의 비용까지 정확히 포함하지는 않는다. Dense Transformer의 Dense는 각 토큰이 각 층의 주요 가중치를 모두 사용하는 구조를 뜻한다. MoE(mixture of experts)처럼 토큰마다 일부 expert만 선택하는 구조에서는 전체 파라미터 수를 그대로 에 넣을 수 없다.
1-2. Power law와 loss modeling
Power law는 한 양이 다른 양의 거듭제곱에 비례하는 관계다. 기본 형태는 다음과 같다.
는 비례상수이고 는 실수 지수다. 일 때, 이면 가 커질수록 함수값이 증가하고, 이면 감소한다.3 예를 들어 에서 입력을 에서 로 늘리면(),
로 함수값이 절반이 된다.
이 관계를 모델 크기와 loss에 적용해 보자. 학습 데이터 조건을 고정하고, 모델 크기를 늘릴수록 loss가 2에 가까워지는 예시를 생각하자. 는 billion 단위의 파라미터 수이고, 는 모형이 예측한 loss다.
모델을 1B→4B→16B로 키우면 loss는 3→2.5→2.25가 되므로 전체 loss의 감소량은 점점 작아진다. 여기서 power law를 따르는 것은 다. 이를 일반화하면 로 쓸 수 있다. 는 상수이고, 감소하는 관계를 나타내기 위해 , 으로 두고 지수에 음수를 붙였다. 실제 실험에서는 이런 모형이 관측된 loss를 잘 설명하는지 확인하고 계수를 추정해야 한다.
1-3. 실험에 의한 loss modeling
먼저 여러 크기의 모델을 여러 학습 토큰 수로 훈련하고, 각 실험의 을 기록한다. 이 점들에서 규모가 커질수록 loss가 어떻게 줄어드는지 관찰한 뒤, 그 경향을 설명할 수식을 정하고 계수를 추정한다. 이렇게 관측값에 수식을 맞추는 과정을 fitting이라고 한다. 추정에 사용하지 않은 실험에서도 맞는지 확인해야 큰 규모의 예측에 쓸 근거가 생긴다. 몇 번 실험했는지뿐 아니라, 모델 크기와 데이터량의 어떤 범위를 실험했는지도 중요하다.
Kaplan et al. (2020). 이 논문에서 는 데이터셋에 들어 있는 토큰 수다. 앞서 정의한 누적 학습 토큰 수 와 구분하기 위해 여기서는 으로 쓴다. 예를 들어 10억 토큰짜리 데이터셋을 세 번 전부 학습하면 억이지만, 계산량 에 들어가는 는 30억이다.2
논문의 전체 실험 범위는 embedding을 제외한 파라미터 수 768개부터 1.5B, 데이터셋 크기 22M부터 23B 토큰에 걸친다. 아래 그림은 모델 크기와 데이터셋 크기 변화에 따른 실험이다. 데이터셋이나 모델 중 하나가 작으면 다른 하나를 키워도 loss 감소가 둔해지는 모습을 볼 수 있다.

모델 크기와 데이터셋 크기에 따른 조기 종료(early stopping) 시점의 test loss를 함께 표현한 식은 아래와 같다.
는 실험 데이터에 맞춰 추정하는 상수이고, 는 각 자원에 따른 loss 감소율을 결정한다. 데이터셋이 충분히 커서 두 번째 항을 무시할 수 있으면 이 남는다. 이는 모델 크기 에 대해 지수가 인 power law다. 반대로 모델이 충분히 커서 첫 번째 항을 무시할 수 있으면 이 남는다. 이는 데이터셋 크기 에 대해 지수가 인 power law다.2
계산 예산의 최적 배분도 분석하여, 예산이 늘어날 때 모델 크기를 학습 토큰 수보다 더 빠르게 늘리는 것이 유리하다는 결론을 제시했다. 다만, 이 계산량 분석에서는 고정된 학습 길이와 learning rate schedule의 중간 loss를 활용했다. epoch으로 비유하면, 100 epoch에 맞춘 schedule로 학습하다가 50 epoch 시점의 loss로 분석하는 셈이다.24
Hoffmann et al. (2022), Chinchilla. 기존의 배분이 최적인지 다시 검증하면서, 짧게 학습하는 모델에는 schedule도 그 길이에 맞춰야 한다고 지적했다. 위 비유에서는 처음부터 50 epoch에 맞춘 schedule로 learning rate를 낮추며 학습을 마친 뒤 loss를 비교하는 것이다. 같은 학습량이라도 긴 schedule의 중간 loss로 비교하면 짧은 학습의 성능을 실제보다 낮게 평가할 수 있기 때문이다. 논문에서는 이 길이를 epoch 대신 학습 토큰 수로 정한다. 또한 더 큰 모델까지 실험 범위를 넓혀 기존 결론이 유지되는지 확인했다.4
모델 크기 약 70M부터 16B 이상, 학습 토큰 수 5B부터 500B에 걸쳐 400회가 넘는 학습 실험을 수행했다. 같은 모델 크기도 학습 길이와 그에 맞춘 schedule을 바꾸어 여러 번 훈련했다. 이 실행들의 최종 loss에 맞춘 모형은 다음과 같다. 이때 논문은 데이터를 한 번 미만 사용하는 조건에서, 평활화한 training loss를 test loss의 추정값으로 사용했다.4
는 실험에 맞춰 추정하는 양수다. 는 irreducible loss term으로, 모델과 데이터를 함께 늘릴 때 이 모형이 예측하는 점근적 loss다. 를 고정하면 가 에 대해 지수 인 power law를 따른다. 마찬가지로 을 고정하면 가 에 대해 지수 인 power law를 따른다.
계산 예산의 최적 배분도 분석하여, 예산이 늘어날 때 모델 크기와 학습 토큰 수를 비슷한 배율로 늘리는 것이 유리하다는 결론을 제시했다.4
Hoffmann 모형에서 고정 예산의 최적 N과 D 유도
원래 loss 모형은 두 변수의 함수다. 여기서는 계산 예산을 고정하고 를 제약식 로 놓는다. 그러면 을 정할 때 도 정해지므로, 이를 대입해 만의 함수로 쓸 수 있다. 는 실제 개수 단위다.
모델이 아주 작을 때는 학습 토큰이 많아도 모델 크기가 성능을 제한한다. 이 상태에서 을 키우면 예측 loss가 감소하지만, 고정된 예산에서는 그만큼 가 줄어든다. 모델을 계속 키우면 부족한 학습량의 영향이 더 커져 예측 loss가 다시 증가한다. 우리가 찾으려는 것은 이 모형에서 loss가 감소하다가 증가로 돌아서는 최솟값이다. 그 지점에서는 에 대한 loss의 기울기가 0이므로, 위 식을 에 대해 미분해 0으로 놓으면
를 얻는다. 양변에 를 곱하고 정리하면
양변을 제곱하면
이를 에 대입하면
다음과 같이 상수와 지수를 묶으면
원논문의 식 (4)와 같은 형태가 된다.4
2. Compute-optimal training
이제 앞에서 얻은 loss 모형을 계산 예산의 배분에 적용해 보자. 같은 계산 예산에서 가장 낮은 loss를 얻으려면 모델 크기()와 학습 토큰 수()를 어떻게 배분해야 할까?
2-1. 같은 계산량에서의 비교
FLOPs를 배정한 가상 실험을 생각하자.
| 후보 | 모델 크기 | 학습 토큰 수 | 근사 계산량 |
|---|---|---|---|
| A | 0.5B | 2B | |
| B | 1B | 1B | |
| C | 2B | 0.5B |
계산량은 같지만 어느 후보의 loss가 낮은지는 이 표만으로 알 수 없다. 앞에서 얻은 loss 모형을 이용해 후보를 비교해 보자. 이것이 isoFLOP, 즉 같은 계산량 안에서의 비교다.
예시
, , 라고 두고 를 각각 billion () 단위로 넣자. 앞 표의 A는 , B는 3.000, C는 3.121이다. 이 예시에서는 B로 배분하는 것이 가장 좋다.
2-2. Chinchilla
실제 실험에서도 같은 계산 예산 안에 최적의 데이터/모델 사이즈 조합이 나타날까? Hoffmann은 부터 FLOPs까지 9개 계산 예산을 정하고, 각 예산에서 모델 크기와 학습 토큰 수의 조합을 바꾸었다. Figure 3는 그 결과다.4

왼쪽 그림에서 같은 곡선 위에서는 계산량이 고정되어 있으므로 오른쪽으로 갈수록 은 늘고 는 줄어든다. 각 곡선의 최저점이 해당 예산에서의 최적 조합이다. 가운데와 오른쪽 그림은 이 최적점들을 모아 계산 예산에 따른 최적 모델 크기와 학습 토큰 수를 각각 추정한다. 두 축을 로그 척도로 그렸을 때 대략 직선으로 나타나는 관계를 power law로 맞춘 것이다.
이 예측을 훨씬 큰 모델에서도 확인한 실험이 Chinchilla다. Gopher는 280B 파라미터를 300B 토큰으로 학습한 모델이다.5 그림의 초록색 선은 Gopher의 학습 계산 예산에서 예측한 최적 모델 크기와 학습 토큰 수를 표시한다. Chinchilla는 이 분석을 바탕으로 70B 파라미터와 1.4T 학습 토큰을 사용해 학습했다. 로 근사한 계산량은 Gopher가 약 , Chinchilla가 약 FLOPs로, 두 모델은 비슷한 계산 예산을 사용했다. Chinchilla는 더 작은 모델을 더 많은 토큰으로 학습해 아래 평가에서 더 높은 정확도를 얻었다.4
| 평가 · 정확도(%) | Gopher (=280B, =300B) | Chinchilla (=70B, =1.4T) |
|---|---|---|
| MMLU · 5-shot | 60.0 | 67.6 |
| LAMBADA · zero-shot | 74.5 | 77.4 |
| RACE-h · few-shot | 71.6 | 82.3 |
출처: Hoffmann et al. (2022), Training Compute-Optimal Large Language Models, Tables 6–7에서 발췌.
2-3. 데이터 반복과 제약
Pre-training에서 데이터 풀의 크기와 학습에서 소비한 토큰 수를 구분했다. 예를 들어 다음 두 실행은 같은 모델을 학습한다면 로 계산한 연산량이 같다.
| 구성 | 고유 데이터량 | 평균 반복 횟수 | 소비 토큰 수 |
|---|---|---|---|
| 새로운 문서를 한 번씩 읽기 | 100B | 1회 | 100B |
| 같은 문서를 반복해서 읽기 | 10B | 10회 | 100B |
그렇다고 두 실행의 최종 loss까지 같다고 예측할 수는 없다. 반복해서 읽으면 이미 본 문맥을 더 학습할 수 있지만, 새로운 문맥의 다양성이 같은 속도로 늘지는 않는다.
Muennighoff 등의 Scaling Data-Constrained Language Models는 고유 데이터량과 반복 횟수를 구분해 실험했다. 해당 실험에서는 몇 차례 반복이 유용했지만, 반복을 계속 늘릴 때 추가 계산의 이득은 줄었다. 따라서 새로운 데이터로 얻은 scaling 관계에 반복 토큰 수만 대입해 같은 개선을 기대하기는 어렵다.6

왼쪽 그래프는 모델 크기를 4.2B로 고정하고 같은 데이터를 반복해서 학습할 때의 test loss를 보여준다. 가로축은 총 학습 토큰 수이고 괄호는 반복 수, 세로축은 test loss다. 주황색 점선은 반복 토큰도 새로운 토큰과 같은 가치가 있다고 가정해 Chinchilla 모형을 적용한 예측이고, 주황색 실선은 반복할수록 추가 효과가 줄어드는 것을 반영한 이 논문의 예측이다. 원으로 표시된 실제 학습 결과를 보면, 약 4 epochs까지는 두 예측의 차이가 작지만, 반복이 늘면 실제 결과는 점선보다 실선에 가깝다. 즉, 반복 학습으로 loss를 더 낮출 수는 있지만, 새로운 데이터를 계속 추가할 때와 같은 개선이 이어지지는 않는다.
오른쪽 그래프는 고유 데이터가 25B 토큰으로 제한될 때 같은 계산 예산을 어떻게 배분할지 비교한다. 가로축은 총 학습 토큰 수이고 괄호는 반복 수, 세로축은 모델 파라미터 수다. 검은 실선은 반복 데이터에도 Chinchilla 모형을 그대로 적용하여, 반복 토큰을 새 토큰처럼 취급했을 때의 최적 배분이고, 붉은색에서 주황색으로 이어지는 선은 이 논문이 예측한 최적 배분이다. 파란 점선은 계산량이 같은 조합들이므로, 그 위에서는 모델을 줄일수록 더 오래 학습할 수 있다. 각 배분선과 파란 점선이 만나는 별표를 실제로 비교하면, 모델을 줄이고 반복을 늘린 빨간 별이 노란 별보다 낮은 loss를 얻었다. 이 결과를 이해하려면 데이터가 부족하면 반복 학습뿐 아니라 모델을 더 키우는 효과도 줄어든다는 점을 함께 보아야 한다. 이 논문의 실험에서는 추가 파라미터의 효과가 반복 학습의 효과보다 더 빠르게 감소했기 때문에, 같은 계산 예산에서 모델을 조금 줄이고 반복을 늘리는 배분이 유리했다.6
3. Emergent abilities
3-1. 관측된 능력의 출현
Pre-training에서 평균 NTP loss와 downstream 과제 정확도를 함께 보았다. 여기서도 두 지표를 구분한다. 평균 loss가 조금씩 낮아질 때, 특정 문제를 푸는 성공률도 같은 모양으로 좋아질까?
Gopher 연구는 학습 토큰량은 300B로 고정하고 모델 크기에 따른 차이를 152개 과제에서 평가했다. 독해·사실 확인 등에서는 규모 증가의 이득이 컸지만, 논리·수학 추론에서는 상대적으로 작았다. 과제별로 다른 개선을 가져온다는 사례다.5

일부 과제에서는 작은 모델들의 성능이 무작위 응답 수준에 머물다가, 더 큰 모델에서 크게 향상되는 모습이 관측된다. Wei 등은 작은 모델의 성능 추세만으로 예상하기 어려운 이러한 능력의 출현을 emergent ability로 정리했다.7
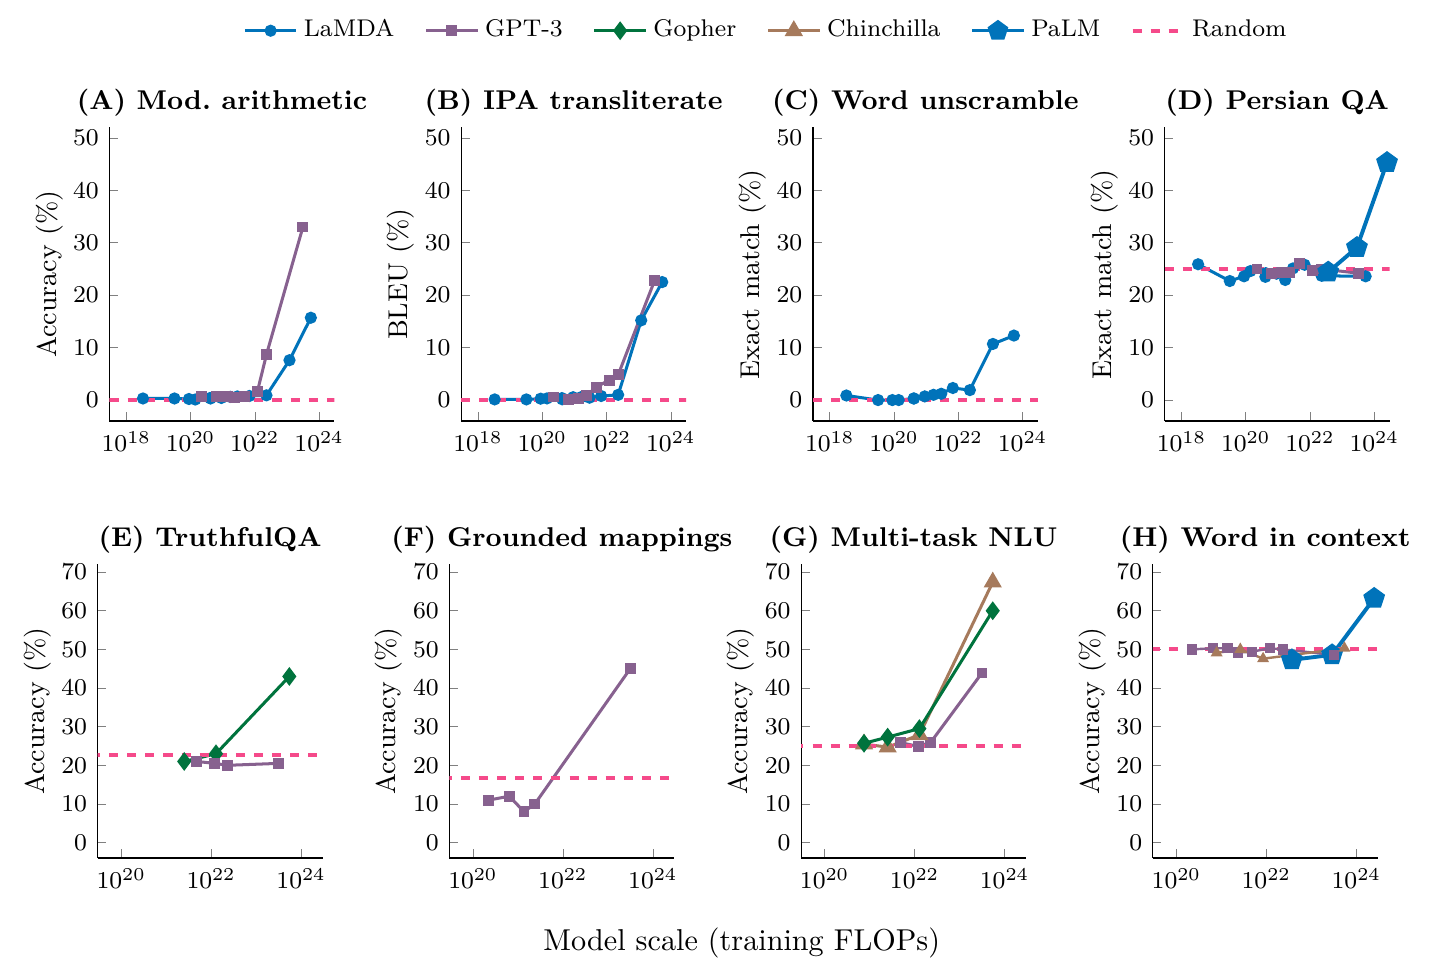
가로축의 training FLOPs는 모델 크기와 학습 토큰 수를 함께 반영한다. GPT-3와 PaLM은 학습 토큰 수를 고정하고 모델 크기를 늘렸지만, LaMDA와 Chinchilla는 학습 토큰 수도 모델마다 다르다. 원논문의 Appendix D에는 같은 결과를 파라미터 수를 가로축으로 다시 그린 그림도 있다.7
모델별 파라미터 수·학습 토큰 수·FLOPs: Appendix C
| Model | Parameters | Train tokens | Train FLOPs |
|---|---|---|---|
| GPT-3 | 125M | 300B | 2.25E+20 |
| 350M | 300B | 6.41E+20 | |
| 760M | 300B | 1.37E+21 | |
| 1.3B | 300B | 2.38E+21 | |
| 2.7B | 300B | 4.77E+21 | |
| 6.7B | 300B | 1.20E+22 | |
| 13B | 300B | 2.31E+22 | |
| 175B | 300B | 3.14E+23 | |
| LaMDA | 2.1M | 262B | 3.30E+18 |
| 17M | 313B | 3.16E+19 | |
| 57M | 262B | 8.90E+19 | |
| 134M | 170B | 1.37E+20 | |
| 262M | 264B | 4.16E+20 | |
| 453M | 150B | 4.08E+20 | |
| 1.1B | 142B | 9.11E+20 | |
| 2.1B | 137B | 1.72E+21 | |
| 3.6B | 136B | 2.96E+21 | |
| 8.6B | 132B | 6.78E+21 | |
| 29B | 132B | 2.30E+22 | |
| 69B | 292B | 1.20E+23 | |
| 137B | 674B | 5.54E+23 | |
| Gopher | 417M | 300B | 7.51E+20 |
| 1.4B | 300B | 2.52E+21 | |
| 7.1B | 300B | 1.28E+22 | |
| 280B | 325B | 5.46E+23 | |
| Chinchilla | 417M | 314B | 7.86E+20 |
| 1.4B | 314B | 2.63E+21 | |
| 7.1B | 199B | 8.47E+21 | |
| 70B | 1.34T | 5.63E+23 | |
| PaLM | 8B | 780B | 3.74E+22 |
| 62B | 780B | 2.90E+23 | |
| 540B | 780B | 2.53E+24 | |
| Anthropic LM | 800M | 850B | 4.08E+21 |
| 3B | 850B | 1.53E+22 | |
| 12B | 850B | 6.12E+22 | |
| 52B | 850B | 2.65E+22 |
출처: Wei et al. (2022), Emergent Abilities of Large Language Models, Appendix C
다만, 그래프의 급격한 변화만으로 내부 능력이 불연속적으로 생겼다고 결론 내릴 수는 없다. Schaeffer 등은 모델이 생성한 덧셈·곱셈 답안을 그대로 두고 채점 방식만 바꾸어 비교했다. 답 전체가 맞았는지를 평가하는 정확도 대신, 정답으로 고치는 데 필요한 최소 토큰 삽입·삭제·치환 횟수(token edit distance)로 평가하면 일부 급격한 향상이 더 점진적인 개선으로 보일 수 있음을 분석했다.8
예를 들어 정답이 1234인 문제에 작은 모델은 9876, 큰 모델은 1235라고 답했다고 하자. 전체 정답 여부로 채점하면 둘 다 0점이다. 하지만 숫자 하나를 토큰 하나로 세면, 정답으로 고치는 데 필요한 수정 횟수는 4회에서 1회로 줄었다. 즉, 완전히 맞히기 전에도 정답에 가까워지는 개선이 있었지만, 전체 정답 여부만으로는 그 차이가 드러나지 않는다. 평가 방식이 그 변화를 어떻게 드러내는지도 살펴봐야 한다.
Footnotes
-
Li, M., Kudugunta, S., & Zettlemoyer, L. (2025). (Mis)Fitting: A Survey of Scaling Laws. arXiv:2502.18969v1. ↩
-
Kaplan, J., et al. (2020). Scaling Laws for Neural Language Models. arXiv:2001.08361. ↩ ↩2 ↩3 ↩4 ↩5
-
Newman, M. E. J. (2005). Power laws, Pareto distributions and Zipf’s law. Contemporary Physics, 46, 323–351. arXiv:cond-mat/0412004v3. ↩
-
Hoffmann, J., et al. (2022). Training Compute-Optimal Large Language Models. NeurIPS 2022. arXiv:2203.15556v1. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
Rae, J. W., et al. (2021). Scaling Language Models: Methods, Analysis & Insights from Training Gopher. arXiv:2112.11446v2. ↩ ↩2
-
Muennighoff, N., et al. (2023). Scaling Data-Constrained Language Models. arXiv:2305.16264v3. ↩ ↩2
-
Wei, J., et al. (2022). Emergent Abilities of Large Language Models. Transactions on Machine Learning Research. arXiv:2206.07682v2. ↩ ↩2
-
Schaeffer, R., Miranda, B., & Koyejo, S. (2023). Are Emergent Abilities of Large Language Models a Mirage? NeurIPS 2023. arXiv:2304.15004v2. ↩