Week 1
BERT vs GPT
앞 노트에서 조립한 Transformer를 바탕으로 attention mask와 학습 목표의 관계를 살펴본다. Zhao 등의 LLM 서베이1를 큰 지도로 삼아, BERT2와 GPT345, 그리고 encoder–decoder인 T5를 비교한다. 구조의 차이가 어떤 입력을 볼 수 있는지, 어디에 loss를 걸고 어떻게 활용하는지로 이어지는 것이 핵심이다.
1. Attention mask
Transformer 블록의 self-attention 은 행렬의 어느 성분을 살리고 어느 성분을 로 덮느냐에 따라 두 가지로 갈린다.
- 양방향(bidirectional) attention: mask 없음. 위치 가 문장의 모든 위치를 본다. 전체 입력의 문맥을 활용한다. 이 상태로 바로 다음 토큰을 정답으로 삼으면 정답을 입력에서 본 셈이므로, BERT는 입력을 일부 손상시키는 별도 학습 목표를 쓴다. BERT 계열의 방식이다.
- 인과(causal) attention: causal mask. 위치 는 만 본다. 위치 의 표현은 “지금까지 본 것”만 담으므로 그 자리에서 다음 토큰 을 예측하는 것이 잘 정의된다. GPT 계열이 생성(generation)에 쓰는 방식이다.
행 = query 위치 , 열 = key 위치 . 채워진 칸이 attention 이 허용된 쌍이다.
왜 한쪽은 encoder, 다른 쪽은 decoder 라 부르나. 원 Transformer(§1a)에는 스택이 둘이었다: 입력 문장을 양방향으로 읽어 표현으로 바꾸는 encoder, 그 표현을 참조해 출력을 왼쪽에서 오른쪽으로 써 나가는 decoder. “읽기”에는 mask 가 필요 없고, “쓰기” 에는 causal mask 가 필요하다. 두 계열은 이 스택을 하나씩 떼어 온 것이다:
- BERT = encoder-only: §1a 의 블록(self-attention + FFN)을 mask 없이 쌓은 것. 원 Transformer 의 encoder 스택 그대로다.
- GPT = decoder-only: 같은 블록에 causal mask 를 건 것. 원 Transformer 의 decoder 블록에는 encoder 를 들여다보는 sub-layer(encoder–decoder attention)가 하나 더 있지만, GPT는 참조할 encoder가 없으므로 cross-attention sub-layer를 뺀다. 그러면 encoder 블록과 causal mask 하나로만 갈린다.
여기서는 mask의 효과를 비교하기 위해 블록의 공통 골격을 놓고 본다. 실제 모델은 출력층 외에도 정규화(normalization) 위치, 활성화 함수(activation function), 위치 표현 등이 다를 수 있다. 그림의 잔차 연결(residual connection)은 sub-layer의 입력을 출력에 더하는 경로다. 아래 그림은 그러한 구현 차이를 생략한 비교다.
그래서 encoder 를 쌓는다 = 매 층에서 각 토큰이 좌·우 문맥을 함께 흡수해 표현이 점점 정교해지고, 마지막에 그 표현 위에 분류기 같은 얇은 층을 얹는다. decoder 를 쌓는다 = 매 층에서 각 토큰이 왼쪽 문맥만 반영한 표현을 만들고, 마지막 위치의 표현이 곧 “다음에 올 토큰”의 예측이 된다. 그걸 이어 붙이면 생성이다. 층을 아무리 쌓아도 이 성격은 그대로다.
2. BERT
BERT(Bidirectional Encoder Representations from Transformers)2 는 §1a 의 블록을 mask 없이 쌓은 encoder-only 스택이다(BERT-base: 12층, , 12 head, 110M 파라미터). 각 위치가 문장 전체를 보므로 표현은 풍부하지만, 그 대가로 “다음 토큰” 이라는 학습 목표를 쓸 수 없다. 예측해야 할 토큰까지 이미 입력에서 봐 버리기 때문이다. 그래서 BERT 는 다른 학습 과제를 만든다.
2-1. MLM
Masked language modeling(MLM)은 입력 일부를 손상시키고 원래 토큰을 맞히는 과제다. BERT는 토큰의 약 15%를 예측 대상으로 고른다. 우선 선택된 위치를 가리는 예부터 보자.
입력:   고양이가 [???] 위에 앉았다
정답:   방석
위치 를 맞히려면 의 왼쪽(“고양이가”)과 오른쪽(“위에 앉았다”)을 모두 봐야 하므로, 학습이 끝나면 모든 토큰의 표현에 양방향 문맥이 담긴다. 이것이 BERT 표현이 “bidirectional” 인 이유다.6
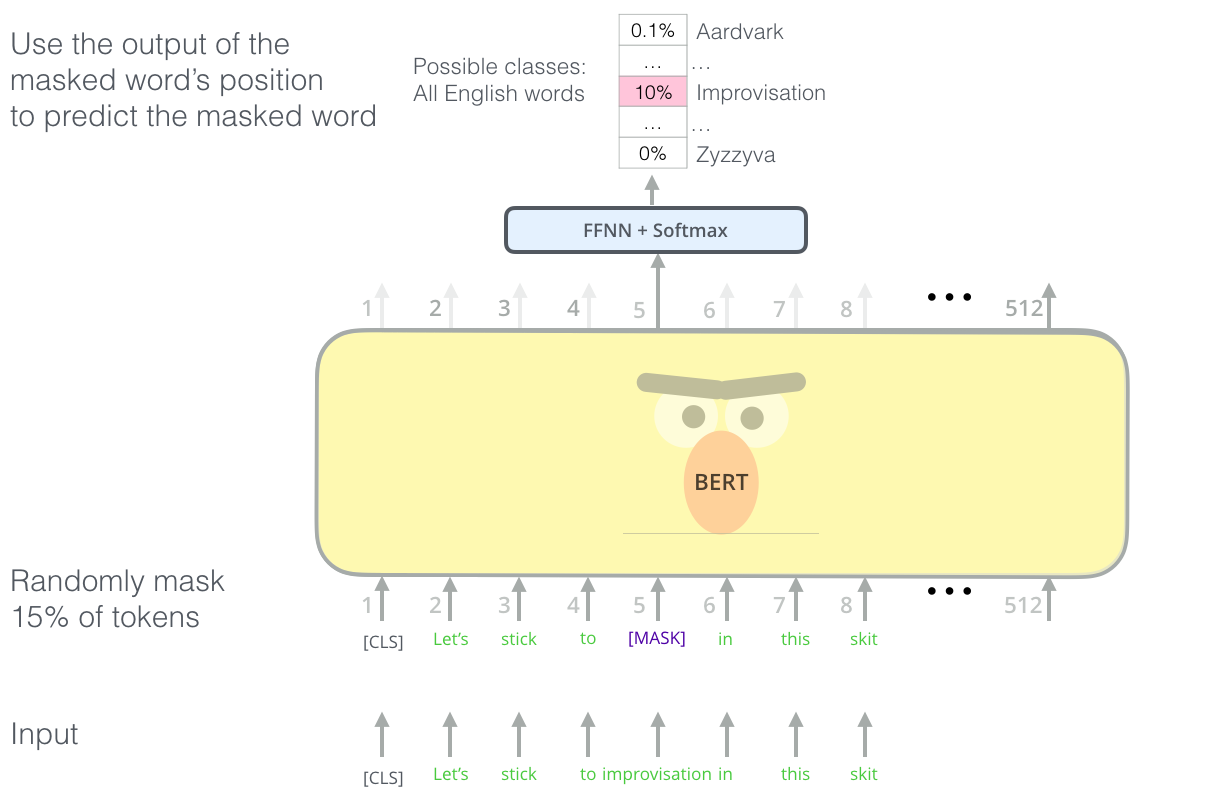
가리는 방법에는 사연이 있다. 매번 특수 토큰 [MASK] 로만 바꾸면, 모델은 [MASK] 가
보이는 자리에서만 예측을 준비하게 된다. 그런데 정작 downstream 과제(분류·태깅 등)의
입력에는 [MASK] 가 없다. 학습 때만 보던 표식이 실전에서 사라지는 불일치다. 이를
줄이려고, 고른 15% 를 이렇게 나눠 처리한다.
- 80%:
[MASK]로 바꾼다. 기본 케이스. - 10%: 엉뚱한 임의 토큰으로 바꾼다. 모델은 “이 자리 단어가 문맥에 안 맞는다”를 알아채고 원래 토큰을 복원해야 한다.
- 10%: 그대로 둔다. 겉보기엔 멀쩡한 이 자리도 모델은 (원본인지 아닌지 모른 채) 예측을 내야 한다.
선택한 15%에는 세 경우 모두 loss를 건다. 토큰을 그대로 둔 위치에도 정답이 있고, 나머지 85%는 문맥으로 쓰되 MLM loss를 걸지 않는다. 따라서 “보이는 [MASK] 위치”와 “채점하는 위치”는 같지 않다.
2-2. NSP
BERT는 MLM과 함께 next sentence prediction(NSP)도 학습했다. 문장 두 개 A, B 를 이어 붙여 넣고 “B 가 원문에서 실제로 A 다음에 오던 문장인가?”를 예·아니오로 맞히게 한다. 질의응답·자연어 추론처럼 문장 쌍 관계가 중요한 과제를 겨냥한 장치였지만, 이후 연구(RoBERTa7) 에서는 해당 학습 설정에서 NSP를 제거해도 성능을 유지하거나 개선할 수 있음을 보였다. 모든 문장 관계 학습이 불필요하다는 결론은 아니다.
2-3. 과제별 활용
BERT는 입력 토큰마다 양방향 문맥 표현을 만든다. 입력 맨 앞에 [CLS], 문장 경계에 [SEP]를 둔다. 문장 분류에서는 [CLS]의 최종 표현에 분류 head를 붙이고, 개체명 인식에서는 각 토큰의 최종 표현에 태깅 head를 붙인다. 과제 데이터로 BERT와 head를 함께 fine-tuning하는 것이 대표적인 활용 방식이다.
BERT 계열이 지금도 쓰이는 자리는 분류, 검색용 임베딩(retrieval), 리랭킹 처럼 입력을 한 번에 이해하기만 하면 되고 생성이 필요 없는 곳이다. 이런 용도는 생성형 LLM 시대에도 encoder가 유용한 선택지다. 생성 루프 없이 한 번의 forward로 표현을 얻지만, 품질과 비용은 모델 크기·과제·학습 방식에 따라 비교해야 한다.
3. GPT
3-1. Next-token prediction
GPT(Generative Pre-trained Transformer)3 는 §1에서 봤듯 원 Transformer 의 decoder 블록에서 encoder–decoder attention(cross-attention)을 뺀 스택이다(GPT-1: 12층, 117M). 참조할 encoder 가 없으니 masked self-attention 과 FFN 만 남는다. 사전학습의 기본 목표는 causal mask 아래의 next-token prediction이다:
문장 하나가 학습에서는 “위치마다 다음 토큰 맞히기” 문제로, 사용에서는 “뽑은 토큰을 도로 이어 붙이기” 절차로 쓰인다. 두 경우 모두 같은 모델과 causal mask를 사용한다.
학습 (teacher forcing, 앞 노트 §3-2): "고양이가 방석 위에 앉았다" 한 문장에서:
  고양이가              → 방석
  고양이가 방석          → 위에
  고양이가 방석 위에      → 앉았다
  세 예측을 causal mask 덕분에 한 번의 forward 로 병렬 채점한다.

생성: 프롬프트에서 시작해 뽑은 토큰을 도로 입력에 붙인다:
  1.  고양이가            → 방석
  2.  고양이가 방석        → 위에
  3.  고양이가 방석 위에    → 앉았다
3-2. Fine-tuning과 in-context learning
다음 변화는 블록보다 모델을 과제에 적용하는 방식에서 두드러진다.
- GPT-13 (2018): generative pre-training + 과제별 discriminative fine-tuning. 아직 BERT 와 같은 “불러와서 fine-tune” 틀.
- GPT-24 (2019, 1.5B): 더 크게, 더 많은 데이터(WebText). fine-tuning 없이 zero-shot 으로 여러 과제를 수행. “언어모델은 비지도 멀티태스크 학습기”.
- GPT-35 (2020, 175B): in-context learning. 파라미터를 안 바꾸고, 프롬프트에 예시 몇 개를 넣는 것(few-shot)만으로 과제를 수행. 이때부터 “모델을 과제에 맞추는” 대신 “프롬프트로 과제를 지시하는” 방식이 널리 주목받았다. Fine-tuning과 prompting은 이후에도 함께 쓰인다.
같은 감성 분류 과제를 두 방식으로 구성해 보자. 아래 문구와 정답은 절차를 설명하는 예시이며, 각 모델의 실제 출력이나 성능을 재현한 것은 아니다.
GPT-1: 라벨 데이터로 fine-tune 한 뒤 사용
  [학습]  ("이 영화 최고였다", 긍정) …수천 건으로 가중치를 갱신
  [사용]  이 영화 최고였다  → 긍정

GPT-2: 가중치 고정, 자연어 지시만으로 (zero-shot)
  리뷰: 이 영화 최고였다
  감정(긍정/부정):        → 긍정

GPT-3: 가중치 고정, 프롬프트에 예시 몇 개를 넣어 (few-shot, in-context learning)
  리뷰: 시간이 아까웠다   감정: 부정
  리뷰: 연기가 훌륭했다   감정: 긍정
  리뷰: 이 영화 최고였다  감정:  → 긍정
GPT-1의 과제별 fine-tuning은 가중치를 갱신하고 분류 head를 사용한다. 위 예의 GPT-2·3 방식은 가중치를 고정한 채 텍스트를 생성해 답한다. 특히 in-context learning은 예시를 입력 문맥으로 제공하는 것이며, 그 예시로 gradient를 계산해 파라미터를 갱신하는 과정이 아니다.
이 차이를 구분해 두면 다음 주의 pre-training과 이후 post-training도 연결된다. 모델이 이미 배운 능력을 프롬프트로 끌어내는 것과, 학습으로 모델 자체를 바꾸는 것은 서로 다른 단계다.
4. Encoder–decoder와 prefix LM
4-1. Text-to-text
세 번째 길은 원래 Transformer 처럼 스택을 둘 두는 것이다.
- encoder 가 입력 문장을 양방향으로 읽어 각 토큰의 표현을 만든다(BERT 처럼).
- decoder 가 출력을 왼쪽에서 오른쪽으로 생성하되(GPT 처럼), 매 스텝 encoder 가 만든 입력 표현도 함께 참조한다. 이 “출력 쪽이 입력 쪽을 들여다보는” attention 이 1a 노트 §3-2의 encoder–decoder attention(= cross-attention)이다.
입력 전체의 표현을 계산한 뒤 출력을 쓰기 시작하는 구조라, 입력과 출력이 뚜렷이 나뉘는 번역·요약에 잘 맞는다(“이 문장(입력)을 이 문장(출력)으로 바꿔라”).
대표가 T58 다. T5 는 모든 과제를 “문자열 하나를 받아 문자열 하나를 내놓는다”로
통일한다. 번역도, 감성 분류도(출력이 "positive" 라는 단어), 문장 유사도도(출력이
"3.8" 이라는 숫자 문자열), 요약도 같은 틀이다.
과제가 번역이든 문법성 판단이든 유사도 점수(회귀)든 요약이든, 입력도 출력도 텍스트
한 덩어리다. 과제의 종류는 입력 맨 앞의 접두사(translate English to German:,
cola sentence: …)로만 지시한다. 도식은 Raffel et al. (2020), Figure 1을 재구성했다. CC BY 4.0, 배치와 표현 수정.
4-2. Span corruption
T5의 사전학습은 span corruption이다. 원문에서 짧은 토큰 구간(span) 몇 개를 무작위로
고르고, 고른 구간을 통째로 특수 토큰 하나로 바꾼다. 이 특수 토큰이 sentinel
(자리표시 토큰)이다. vocabulary 에 미리 넣어 둔, 뜻은 없고 “여기에 구간 하나가 빠졌다”
만 표시하는 토큰이다. 빠진 구간이 여럿이면 첫째는 <X>, 둘째는 <Y>, … 로 서로 다른
sentinel 을 붙인다.
직관은 번호 매긴 빈칸이다. The __(1)__ sat on the __(2)__ .처럼
빈칸마다 번호를 매긴 시험지를 떠올려 보자. 답안지는 그 번호에 답을
짝지어 적는다: (1) cat (2) mat. <X>·<Y> 가 그 번호다. encoder 는 시험지를,
decoder는 학습 때 한 칸 민 답안지를 받는다. 번호가 있으니 decoder 는 빈칸이 여럿이어도 “어느 빈칸의
답인지” 헷갈리지 않고 한 시퀀스에 이어 쓸 수 있다. 그리고 구간이 몇 토큰이든 sentinel
은 하나다. 채울 말이 몇 마디든 빈칸 하나로 표시하기 때문이다. 덕분에 모델은 답의 길이를 미리
못 듣고 스스로 정해야 한다.
아래 예에서는 for inviting과 last 두 구간을 골랐다. 설명을 위해 단어를 토큰처럼 표시하고 EOS(end-of-sequence)는 생략했다. <X>·<Y>·<Z>는 서로 다른 sentinel의 간단한 표기다.
원문:          Thank you for inviting me to your party last week .
encoder 입력:  Thank you <X> me to your party <Y> week .
decoder 정답:  <X> for inviting <Y> last <Z>
- encoder 입력: 고른 구간이 통째로
<X>/<Y>한 토큰으로 줄었다. - decoder 정답: sentinel 을 먼저 쓰고 그 자리에 있던 원래 토큰들을 잇는다:
<X>다음for inviting,<Y>다음last, 마지막에 구간 복원의 끝을 표시하는<Z>. 실제 시퀀스 종료 토큰 EOS와는 구분한다. sentinel 을 앞세우는 것은 decoder 가 “지금 어느 구간을 채우는 중”인지 스스로 표시하기 위해서다.
그래서 sentinel <X>·<Y>·<Z> 자체도 decoder 가 맞혀야 할 정답이고, 거기에도
손실이 걸린다 (정답 문자열에 들어 있으므로). 반대로 encoder 입력 쪽 sentinel 에는
직접 토큰을 맞히는 손실을 걸지 않는다. Encoder의 학습 경로는 다음 절에서 본다.
MLM 과 공유하는 발상: 입력 일부를 가리고 가려진 것을 문맥으로 복원하는 자기지도 목표. 가려지지 않은 부분을 양쪽으로 보고 빈칸을 메운다는 것도 같다.
다른 점, 그리고 T5 가 이쪽을 고른 이유:
- 가리는 단위: MLM 은 토큰 하나씩(
[MASK]), span corruption 은 연속 구간을 통째로. 구간을 sentinel 하나로 접으면 빠진 길이가 안 드러나 모델이 “몇 토큰인지”까지 배운다. - 출력 형태: MLM 은 가려진 자리에서 제자리 분류(입력 위치 ↔ 출력 위치가 1:1). span corruption 은 decoder 가 짧은 시퀀스를 생성한다(빠진 조각만, 순서대로). 그래서 번역·요약·QA 에 바로 필요한 생성 능력을 사전학습에서 함께 기른다. MLM 은 encoder 표현만 기르고 생성은 안 배운다.
- 비용: T5는 보통 원문 토큰의 약 15%를 제거하고, 빠진 토큰과 sentinel·EOS를 target으로 만든다. 원문 전체를 다시 쓰게 하는 BART보다 decoder 시퀀스가 짧다.
- train/test 불일치: MLM 의
[MASK]는 downstream 입력에 안 나타나 80/10/10 로 완화한다. T5는 사전학습과 미세조정 모두 text-to-text 인터페이스를 쓰지만, sentinel을 사용하는 사전학습과 실제 과제 입력의 차이까지 사라지는 것은 아니다.
이 배선(손상 문장 → encoder, 정답 조각 → decoder)은 §1a 의 번역용 encoder–decoder 와 완전히 같다. 넣는 내용만 바뀐다.
| encoder 입력 (조건, 통째로) | decoder 입력 (정답을 한 칸 민 것) | decoder 가 맞힐 정답 | |
|---|---|---|---|
| 원 Transformer · 번역 | That is good . | <s> Das ist gut | Das ist gut <eos> |
| T5 · span corruption | Thank you <X> me … <Y> week . | <s> <X> for inviting <Y> last | <X> for inviting <Y> last <Z> |
표의 <s>는 decoder 시작 입력의 개념 표기이며, T5 구현은 이 자리에 pad token을 사용한다.
규칙은 하나다: encoder 는 조건이 되는 문장을 통째로 받고, decoder 는 정답을 한 칸 민 것을 받아 “그 다음 토큰”을 위치마다 맞힌다.
4-3. Loss와 역전파
Loss는 decoder의 정답 시퀀스에 대해 계산한다. GPT의 next-token loss와 같은 형태지만, T5 decoder는 encoder 표현에도 조건을 둔다. 직접 채점하는 출력이 없다고 encoder가 학습되지 않는 것은 아니다. 역전파(backpropagation)를 통해 loss의 gradient가 decoder와 cross-attention을 거쳐 encoder로 전달되므로 두 스택이 함께 갱신된다.
Encoder와 decoder는 각각 별도 스택을 이룬다. Decoder의 모든 층이 cross-attention 으로 encoder 의 최종 출력을 읽는다. encoder 층은 전부 양방향, decoder 층은 전부 causal(+ cross-attention)이다. 층을 encoder 2 · decoder 2 로 줄여 손실과 그래디언트가 흐르는 길을 그리면:
순전파(forward pass, 실선)에서는 각 스택이 입력을 처리하고, decoder 1층과 2층 모두 encoder의 최종 출력을 cross-attention의 key·value로 사용한다. 그림은 두 층으로 단순화했으며, 실제 T5-base는 encoder와 decoder가 각각 12층이다.8
역전파(backward pass, 점선)는 토큰별 loss를 합산하거나 평균한 학습 loss에서 출발한다. Decoder 2층에서 gradient는 decoder 1층으로 내려가는 경로와, 자체 cross-attention을 통해 encoder 최종 출력으로 돌아가는 경로로 나뉜다. Decoder 1층에서도 자체 cross-attention을 통해 encoder 최종 출력으로 gradient를 전달한다.
Encoder 최종 출력에서는 모든 decoder 층에서 도착한 gradient의 기여를 더한다. 이 합이 encoder 2층, encoder 1층, 입력 임베딩으로 역전파된다. 따라서 decoder 1층이 encoder 1층에 직접 연결되는 것이 아니라, 모든 decoder 층이 공유하는 encoder 최종 출력을 통해 encoder 전체가 학습된다. 그림은 층 사이의 경로를 강조한 것으로, 층 내부의 잔차 연결과 정규화, 임베딩·출력 가중치 공유 경로는 생략했다.
BART9 는 같은 encoder–decoder 이되 입력을 더 다양하게 손상시킨다. 토큰을 지우고, 문장 순서를 섞고, 구간을 마스킹한 문장을 넣어 decoder 가 원문 전체를 되살리게 한다(denoising autoencoder, 잡음 섞은 입력에서 원본을 복원하는 모델).
encoder–decoder 의 대가는 구조가 복잡하다는 것이다(스택 둘 + cross-attention). 또 하나의 모델을 사용할 때 프롬프트를 encoder 입력과 decoder의 생성 부분으로 구분해 구성해야 한다.
4-4. Prefix LM
Prefix LM 은 스택을 하나만 두는 절충안이다. decoder-only 처럼 단일 스택이지만, attention mask 를 입력 구간과 생성 구간으로 나눈다. 프롬프트(prefix)에 해당하는 앞부분은 서로 앞뒤를 다 보게(양방향), 그 뒤 생성하는 부분은 왼쪽만 보게(causal). encoder–decoder 의 “입력은 양방향으로 읽는다”는 성질을 단일 스택의 mask로 구현한다. 별도 encoder나 cross-attention이 있는 것은 아니므로 두 구조가 동등하지는 않다. mask 가 전부 causal 은 아니라는 뜻에서 non-causal decoder 라고도 부른다(GLM 등이 채택).
정리하면 후보는 세 형태다: causal decoder-only, prefix LM(non-causal decoder), encoder–decoder. §5 에서 볼 Wang 등(2022)10 의 비교가 바로 이 셋을 같은 조건에서 나란히 놓은 것이다. 세 구조와 각각의 attention mask 를 그림으로 보려면 T5 논문 §3.2 의 Figure 3–4 가 깔끔하다.8
5. 구조의 선택
5-1. 범용 생성과 decoder-only
GPT-3와 Llama처럼 범용 텍스트 생성에 널리 쓰이는 모델들은 causal decoder-only를 채택했다. 앞의 비교에서 다음 장점을 읽을 수 있다.
- 하나의 생성 인터페이스. 문서, 질문·답변, 예시와 새 문제를 한 시퀀스로 표현하고 다음 토큰을 예측한다. In-context learning도 이 인터페이스에 자연스럽게 들어간다.
- 단순한 계산 구조. 별도 encoder나 cross-attention 없이 같은 스택을 확장한다. 구현과 분산 학습을 한 구조에 집중하기 쉽다.
- 많은 예측 위치. Causal LM은 유효한 다음 토큰 정답마다 loss를 계산한다. BERT의 선택된 약 15%와 다른 점이지만, loss 항의 개수만으로 계산 효율이나 최종 성능의 우열을 증명할 수는 없다.
Wang 등10은 같은 실험 틀에서 아키텍처와 사전학습 목표를 비교했다. 순수 자기지도 사전학습 뒤의 zero-shot 평가에서는 causal decoder와 autoregressive 목표가 강했지만, 멀티태스크 fine-tuning을 추가하면 순위가 달라졌다. 따라서 구조의 효과는 학습 절차와 평가 조건을 함께 놓고 판단해야 한다.
Causal 생성에서는 과거 key·value를 저장하는 KV cache도 쓸 수 있다. 다만 encoder–decoder의 causal decoder나 고정 prefix를 가진 prefix LM도 캐시를 활용할 수 있으므로 decoder-only만의 장점은 아니다. 캐시의 실제 비용은 6주차에서 다룬다.
분류·검색에는 encoder가, 입력과 출력이 구분되는 번역·요약에는 encoder–decoder가 유용할 수 있다. “모든 과제에 가장 좋은 구조” 대신 필요한 출력 형태와 품질·비용을 기준으로 선택한다.
5-2. 세 계열 비교
| BERT (encoder-only) | GPT (decoder-only) | T5 (encoder–decoder) | |
|---|---|---|---|
| attention | 양방향 | causal | encoder 양방향 + decoder causal |
| 사전학습 목적 | MLM (+NSP) | next-token prediction | span corruption |
| 직접 loss를 거는 대상 | 선택된 토큰 약 15% | 유효한 다음 토큰 정답 | 제거한 span + sentinel·EOS |
| 잘 맞는 일 | 분류, 검색 임베딩, 리랭킹 | 범용 생성·대화·추론, in-context learning | 번역·요약 등 입력→출력 과제 |
| 대표 활용 방식 | 과제별 fine-tuning | prompting 또는 fine-tuning | text-to-text fine-tuning |
| 대표 | BERT, RoBERTa, DeBERTa | GPT-3/4, Llama, Mistral, Qwen | T5, BART, FLAN-T5 |
다음 노트는 이 decoder-only 모델을 tokenizer 입력부터 sampling 출력까지 한 바퀴 돌며, Llama 3 8B 로 각 부분의 크기를 확인한다.
Footnotes
-
Zhao, W. X., et al. (2025, v16). A Survey of Large Language Models. arXiv:2303.18223v16. ↩
-
Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL 2019. arXiv:1810.04805. ↩ ↩2
-
Radford, A., Narasimhan, K., Salimans, T., & Sutskever, I. (2018). Improving Language Understanding by Generative Pre-Training. OpenAI 기술보고서. ↩ ↩2 ↩3
-
Radford, A., Wu, J., Child, R., Luan, D., Amodei, D., & Sutskever, I. (2019). Language Models are Unsupervised Multitask Learners. OpenAI (GPT-2, 1.5B). ↩ ↩2
-
Brown, T., et al. (2020). Language Models are Few-Shot Learners. NeurIPS 2020. arXiv:2005.14165 (GPT-3, 175B). ↩ ↩2
-
Alammar, J. (2018). The Illustrated BERT, ELMo, and co.. ↩
-
Liu, Y., et al. (2019). RoBERTa: A Robustly Optimized BERT Pretraining Approach. arXiv:1907.11692. ↩
-
Raffel, C., et al. (2020). Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer. JMLR 21(140). arXiv:1910.10683 (T5). ↩ ↩2 ↩3
-
Lewis, M., et al. (2020). BART: Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension. ACL 2020. arXiv:1910.13461. ↩
-
Wang, T., et al. (2022). What Language Model Architecture and Pretraining Objective Work Best for Zero-Shot Generalization? ICML 2022, PMLR 162. arXiv:2204.05832. ↩ ↩2