Week 1
Transformer 구조
Lin 등의 Transformer 서베이1로 전체 지도를 잡고, 이 노트는 Vaswani 등의 2017년 논문 Attention Is All You Need2 를 1차 자료로 삼아 Transformer 아키텍처를 수식 수준에서 조립한다. 설명 방식과 비유는 이 주제를 잘 풀어낸 해설들 — Alammar 의 The Illustrated Transformer3, Harvard NLP 의 The Annotated Transformer4, Weng 의 Attention? Attention!5, Bloem 의 Transformers from Scratch6 — 을 참고했다. 각 구성요소를 무엇을 계산하는가 · 왜 그렇게 하는가를 중심으로, 예시를 곁들여 본다. 코드는 쓰지 않는다. 이후 노트가 모두 이 블록 위에 서므로, 여기서 텐서 차원을 하나하나 짚고 넘어간다.
1. 전체 구조
1-1. 시퀀스 모델(sequence model)
문장처럼 순서가 있는 데이터를 처리하는 모델을 시퀀스 모델(sequence model)이라고 한다. RNN과 Transformer가 모두 여기에 속한다. 먼저 RNN 기반 모델의 계산 방식과 한계에서 출발하자.
2017년 이전의 기계번역(neural machine translation)은 대부분 RNN(recurrent neural network) 기반 encoder–decoder(seq2seq) 구조였다.7 encoder 가 source 문장을 왼쪽에서 오른쪽으로 한 토큰씩 읽어 hidden state
를 갱신하고, decoder 가 그 정보를 받아 target 문장을 한 토큰씩 생성한다. 여기에 attention을 추가해 decoder 가 매 스텝 source 의 특정 위치를 “돌아보게” 한 것이 Bahdanau 등의 기여였다.8 attention 자체는 Transformer 의 발명이 아니다 — Transformer 의 주장은 순환 연산 없이 attention과 FFN으로 시퀀스를 처리할 수 있다는 것이다.
전체 흐름과 여기에 attention을 추가하는 단계까지는 Alammar 의 단계별 시각화에 있다.9
RNN 방식의 구조적 한계는 두 가지다.
주의
순차 계산(sequential computation). 를 구하려면 이 있어야 한다. 길이 문장의 forward pass 는 번의 순차 스텝을 강제하고, 이 시간축의 의존 관계를 그대로 병렬화할 수는 없다. 시퀀스가 길수록 학습이 느려지고 GPU(graphics processing unit) 활용률이 떨어진다.
주의
장거리 의존성(long-range dependency). 문장 첫 단어의 정보가 마지막 단어에 닿으려면 개의 RNN 스텝을 통과해야 한다. 경로가 길수록 gradient 가 소실·폭발하기 쉽고, 멀리 떨어진 단어 사이의 관계를 학습하기 어렵다.
Transformer는 학습에서 위치들을 병렬로 처리하고, 허용된 두 위치를 attention 한 번으로 연결한다. 이는 순차 계산 경로와 장거리 정보 전달 경로를 줄이지만, 장거리 관계의 학습을 자동으로 보장하지는 않는다. 생성할 때는 여전히 앞서 생성한 토큰을 다음 입력으로 써야 한다.
대신 위치 정보를 별도로 표현해야 하고, 길이 의 전체 시퀀스에 대한 dense self-attention은 개의 위치 쌍을 계산한다. 표현 차원을 고정하면 이 부분의 연산량은 다. 긴 문맥의 학습·입력 처리에서 중요한 비용이며, 토큰 하나씩 생성할 때의 비용은 6주차에서 따로 계산한다.
1-2. Encoder와 decoder
가장 큰 그림부터 잡자. 원 Transformer 는 두 부분으로 나뉜다 — 입력 문장을 읽어 표현으로 바꾸는 encoder 와, 그 표현을 참조해 출력을 한 토큰씩 써 나가는 decoder. 번역이라면 encoder 가 source(영어)를 읽고 decoder 가 target(독일어)을 만든다. 내부 블록은 잠시 접어 두고 이 2부 구조만 먼저 잡으면 나머지가 거기에 붙는다.10
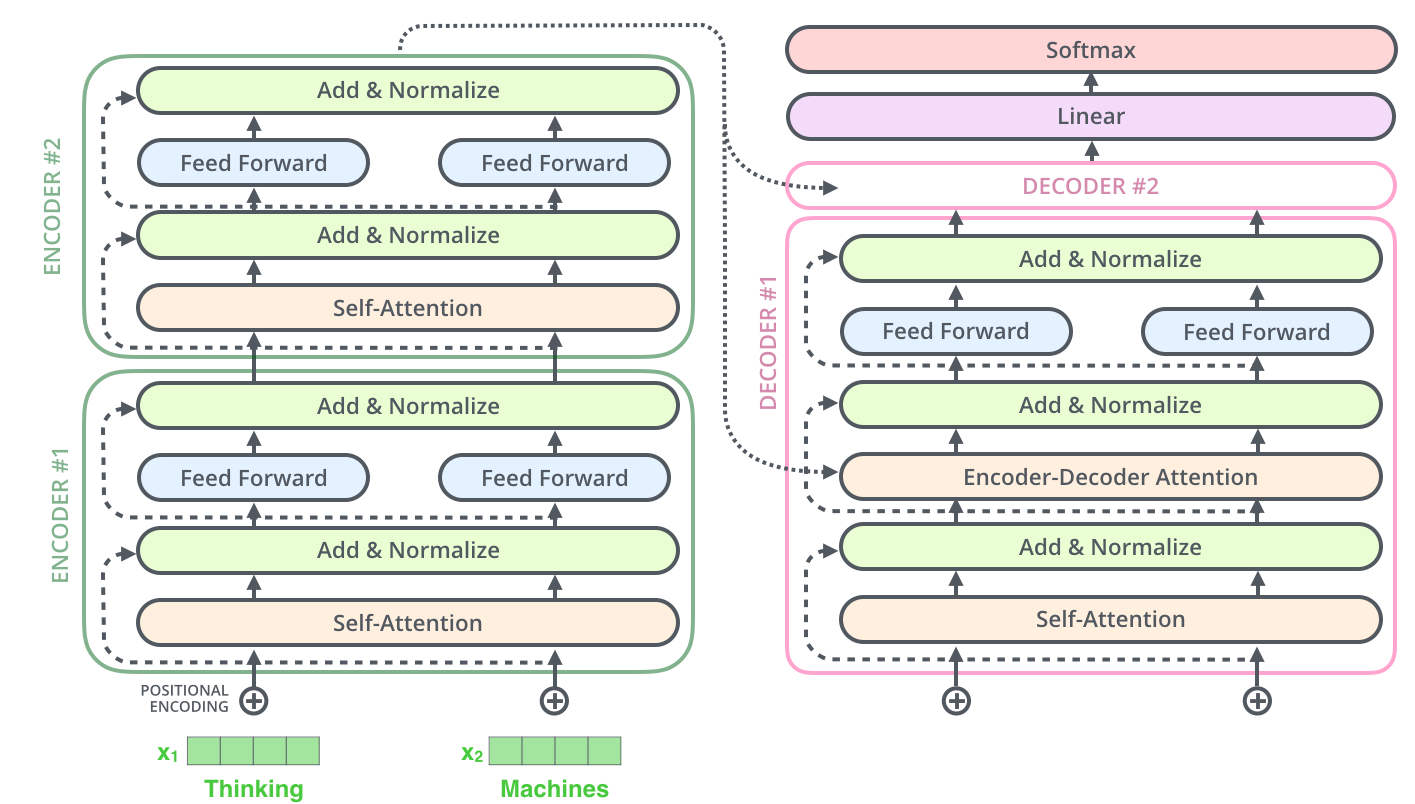
이제 안을 들여다보자. 입력 문장은 먼저 토큰의 열로 쪼개지고, 각 토큰은 학습되는 임베딩 테이블에서 차원 벡터로 바뀐다. 원논문 base 모델에서 다. 길이 문장은 이렇게 행렬
이 된다. 여기에 위치 정보를 더한 뒤(§3-1), 동일한 구조의 블록 개를 통과시킨다 (base 는 ). 블록을 지나도 텐서 모양 은 그대로다 — 블록은 각 토큰 벡터를 “문맥을 반영한 더 나은 벡터”로 다듬을 뿐 개수나 차원을 바꾸지 않는다. 이 모양 보존이 residual connection 과 스택 쌓기를 가능하게 한다.
encoder 블록 하나는 두 개의 sub-layer 로 되어 있다:
- Multi-head self-attention — 각 토큰이 같은 문장의 모든 토큰을 참조해 정보를 모은다.
- Position-wise feed-forward network (FFN) — 모인 정보를 토큰별로 비선형 변환한다.
decoder 블록은 여기에 encoder–decoder attention 이 하나 더 붙어 세 개의 sub-layer 를 가진다(§3-2). 모든 sub-layer 는 residual connection 과 layer normalization(LN) 으로 감싼다(§3-4).
위 그림에서 decoder 아래쪽 입력이 헷갈리기 쉽다. decoder 는 target 문장을 스스로 만들어야 하지만, 학습 때는 정답을 이미 안다. 그래서 정답 문장을 통째로 넣되 한 칸 오른쪽으로 민다 — 위치 의 입력이 정답의 번째 토큰이 되도록. 그러면 위치 는 “정답의 번째 토큰”을 예측하는 문제가 되고, causal mask 가 그 자리에서 미래를 가린다(§3-2). 추론 때는 정답이 없으니 생성한 토큰을 도로 이어 붙여 한 칸씩 늘려 간다.
강조할 점은 encoder 입력과 decoder 입력이 서로 다른 문자열이라는 것이다. 번역이라면 encoder 에는 source(영어) 문장 전체가, decoder 에는 지금까지의 target(독일어)이 들어간다. 두 스택은 나란히 서고, cross-attention 이 그 사이를 잇는 유일한 통로다. 다음 노트의 BERT·GPT·T5 도 모두 이 그림 위에서 갈린다 — BERT 는 왼쪽 기둥만, GPT 는 오른쪽 기둥만 (cross-attention 을 뺀 채), T5 는 이 구조를 거의 그대로 쓴다.
2. Attention
2-1. Query·key·value
Python 딕셔너리를 떠올리자. 키로 조회하면 정확히 일치하는 항목의 값 하나가 나온다. attention 은 이걸 부드럽게 만든 것이다: 쿼리와 모든 키의 유사도를 재고, 그 유사도를 가중치로 삼아 모든 값의 가중 평균(weighted average)을 돌려준다.
- query — “나는 지금 어떤 정보를 찾고 있는가”
- key — “위치 는 어떤 정보를 제공하는가” (색인표)
- value — “위치 가 실제로 건네는 내용”
출력은
로, 는 합이 1인 비음수 가중치다. score 함수로 원논문은 내적 를 쓴다(추가 파라미터가 없고 행렬곱으로 병렬화된다).
예를 들어 두 위치의 score가 이면 softmax 가중치는 다. Value가 각각 과 이면 출력은 이다. Attention은 값 하나를 고르는 대신, query에 따라 섞는 비율을 정한다.
self-attention 에서는 query·key·value 가 모두 같은 입력에서 나온다. 토큰 벡터 하나로부터 세 개의 학습되는 projection 으로
를 만든다. 즉 각 토큰은 “내가 찾는 것()”, “내가 색인되는 방식()”, “내가 내놓는 내용()“을 스스로 정한다.
2-2. 가중합과 행렬 계산
토큰별 벡터를 행으로 쌓아 행렬로 한 번에 계산한다. , , 에 대해
- — 모든 (query 위치, key 위치) 쌍의 내적. 성분은 토큰 가 토큰 에 주는 raw score.
- softmax 는 행별로 적용된다 — 각 query 위치에서 key 들에 대한 확률분포가 된다.
- 이 가중합(weighted sum)을 행렬곱으로 계산한다. 그 확률행렬을 에 곱하면 다시 — 위치마다 value 들의 가중 평균.
행렬곱 두 번과 softmax 한 번으로 모든 query 위치를 함께 계산한다.
2-3. 점수 스케일링
와 의 각 성분이 평균 0, 분산 1로 독립이라고 하자. 그러면 내적
은 평균 0, 분산 (독립 항 개의 합), 따라서 표준편차 다. 면 score 가 대략 규모로 흩어진다. 이렇게 큰 값이 softmax 에 들어가면 분포가 일부 위치로 지나치게 쏠릴 수 있고, softmax의 gradient가 작아져 학습이 어려워질 수 있다. 로 나누면 score 의 분산이 다시 1 근처로 돌아와 softmax가 일찍 포화될 위험을 줄인다.2
직관
스케일링은 “temperature” 조정이다. 로 나누는 것은 softmax 온도를 에 맞춰 올려, 차원이 커져도 attention 이 지나치게 뾰족해지지 않게 유지한다.
2-4. Multi-head attention
한 attention head는 query 위치마다 하나의 가중치 분포를 만든다. 여러 관계를 담을 수 있지만, 서로 다른 가중치 분포를 동시에 쓰려면 head를 여러 개 두는 편이 유연하다. 그런데 문장에는 여러 관계(주어–대명사, 동사–목적어, 수식–피수식)가 동시에 있다.
Multi-head attention은 입력을 개의 학습된 표현 공간으로 각각 선형 사영(linear projection)하고, 각 공간에서 attention을 계산한다. head 마다 별도의 projection
를 두고, 결과를 이어붙인 뒤 한 번 더 섞는다:
원논문은 , 로 잡는다. head 차원을 이렇게 줄여서, multi-head 의 총 계산량은 full-dimension single-head 와 비슷하게 유지된다.
예시
base 모델: , . 각 head 는 64차원에서 attention 을 하고, 8개 head 의 64차원 출력을 concat 해 512차원으로 되돌린 뒤 로 섞는다. head 별 등은 512개 성분을 선형 결합해 64개 성분을 만든다. 원래 좌표 중 64개만 잘라 쓰는 것이 아니다.
학습된 모델을 열어 보면 head 마다 다른 패턴이 보인다 — 어떤 head 는 바로 앞 토큰에, 어떤 head 는 구문상 짝이 되는 토큰에, 어떤 head 는 문장 전체에 고르게 정렬한다.3
3. 블록 구성
3-1. 위치 정보
위치 정보도 mask도 없는 self-attention은 입력 순열에 대해 equivariant하다. 은 위치 의 내용만 보고 그 순서는 모른다 — 입력 토큰을 섞으면 출력도 똑같이 섞일 뿐, 값 자체는 안 바뀐다(permutation equivariant). “개가 사람을 물었다”와 “사람이 개를 물었다”를 구분하려면 순서 정보를 따로 넣는다. Causal mask 자체도 앞뒤의 비대칭을 주므로, 위 성질은 mask 없는 경우의 설명이다.
원논문은 학습 없이 사인·코사인 위치 인코딩을 더한다. 위치 , 차원 인덱스 에 대해
차원마다 파장이 에서 까지 기하적으로 늘어나는 사인파를 배치한 것이다. 낮은 차원은 빠르게 진동해 인접 위치를 구분하고, 높은 차원은 느리게 진동해 긴 범위를 구분한다 — 여러 자리 이진수 카운터와 비슷하다.
이 형태를 고른 이유: 임의의 고정 offset 에 대해 가 의 선형 변환(고정 회전 행렬)으로 표현된다. 모델이 “상대 위치 만큼 떨어진 곳”을 선형 연산으로 참조하기 쉬워진다.2 또 학습 시 본 것보다 긴 문장에도 공식만으로 값을 만들 수 있다.
3-2. Attention 배치와 mask
같은 scaled dot-product attention 이 세 자리에서 쓰인다. 차이는 가 어디서 오는가와 mask 가 있는가뿐이다.
| 위치 | Q 출처 | K, V 출처 | mask | 역할 |
|---|---|---|---|---|
| encoder self-attention | encoder 입력 | encoder 입력 | 없음 | source 토큰끼리 문맥 교환 (양방향) |
| decoder masked self-attention | decoder 입력 | decoder 입력 | causal | 지금까지 생성한 target 토큰끼리 문맥 교환 (왼쪽만) |
| encoder–decoder attention | decoder | encoder 출력 | 없음 | 생성 중 각 위치가 source 문장을 참조 |
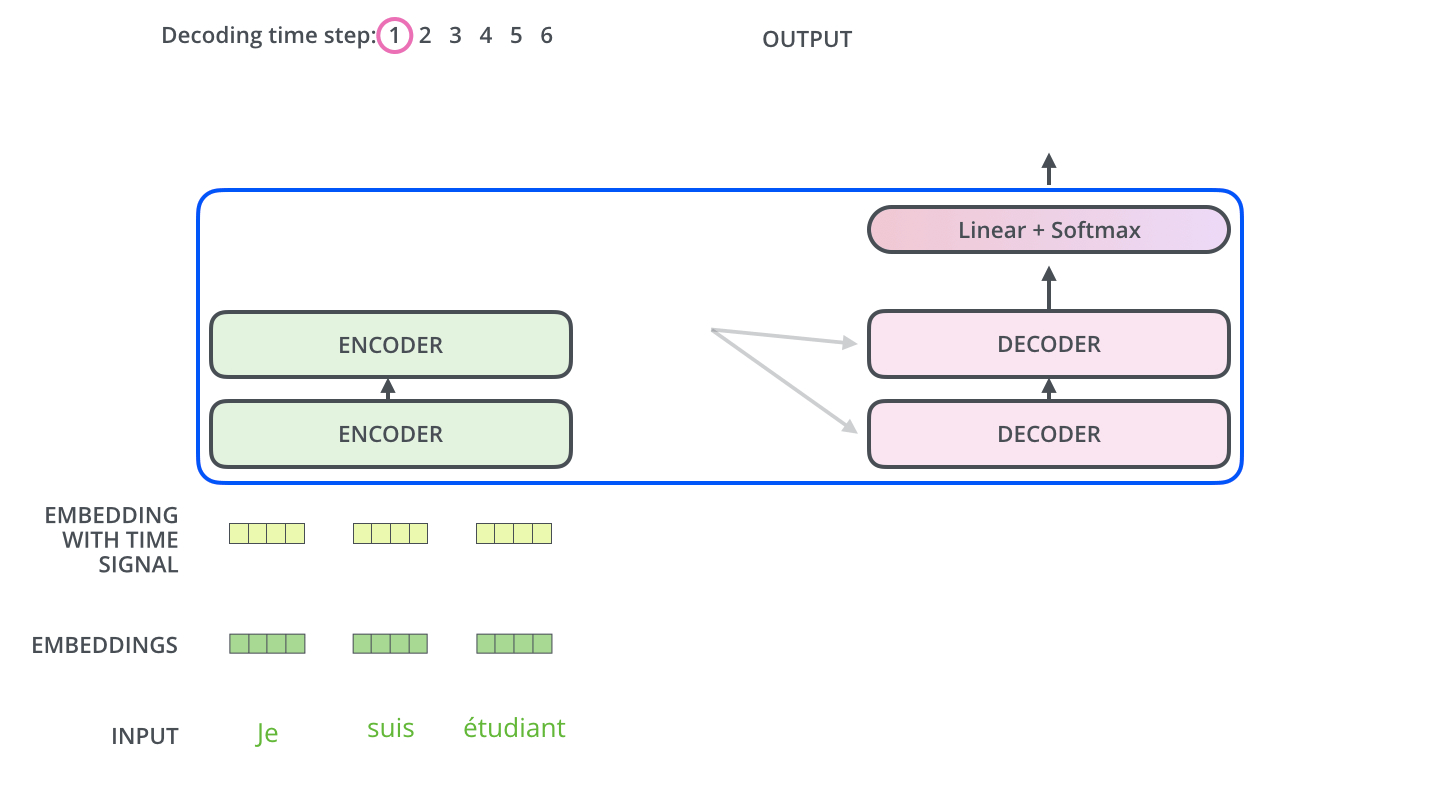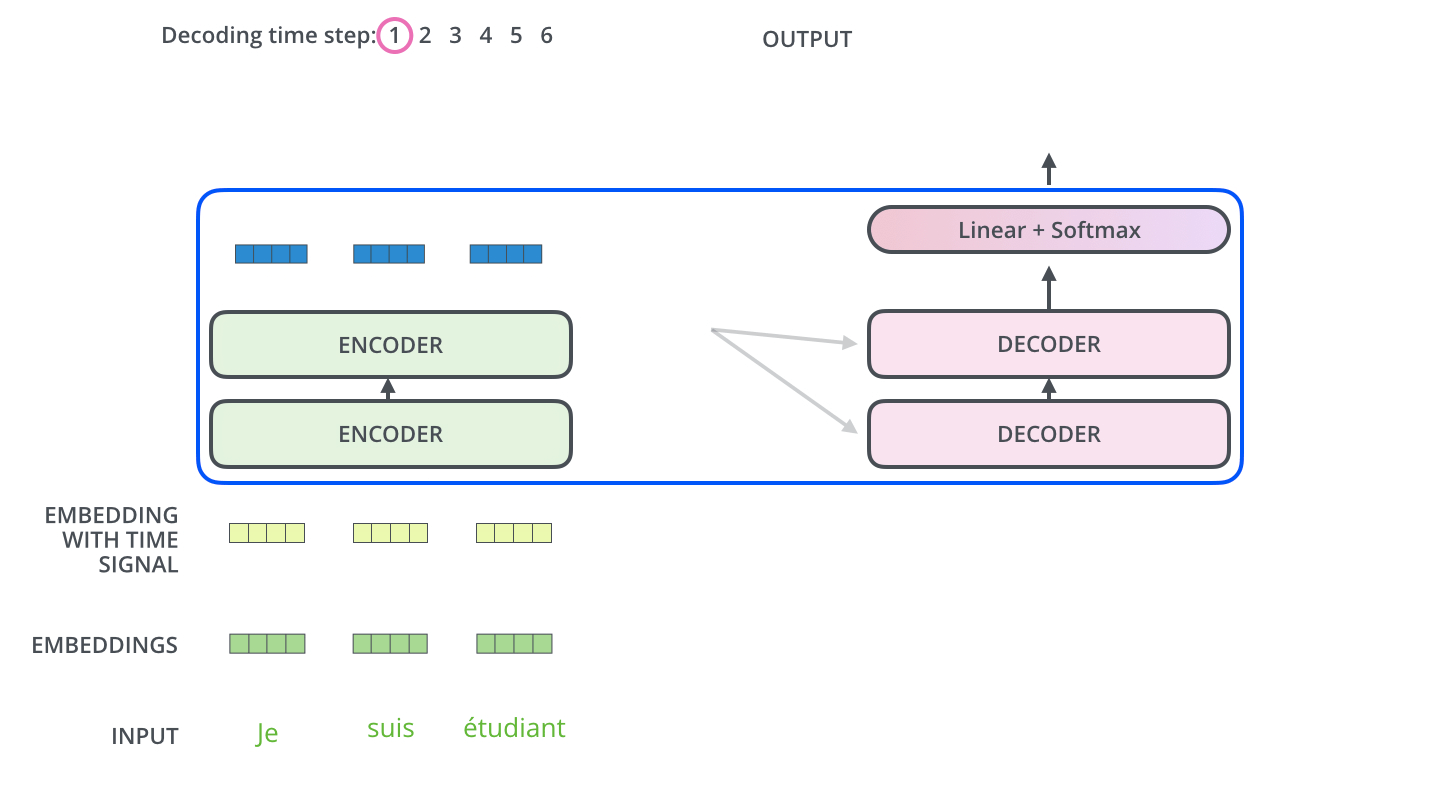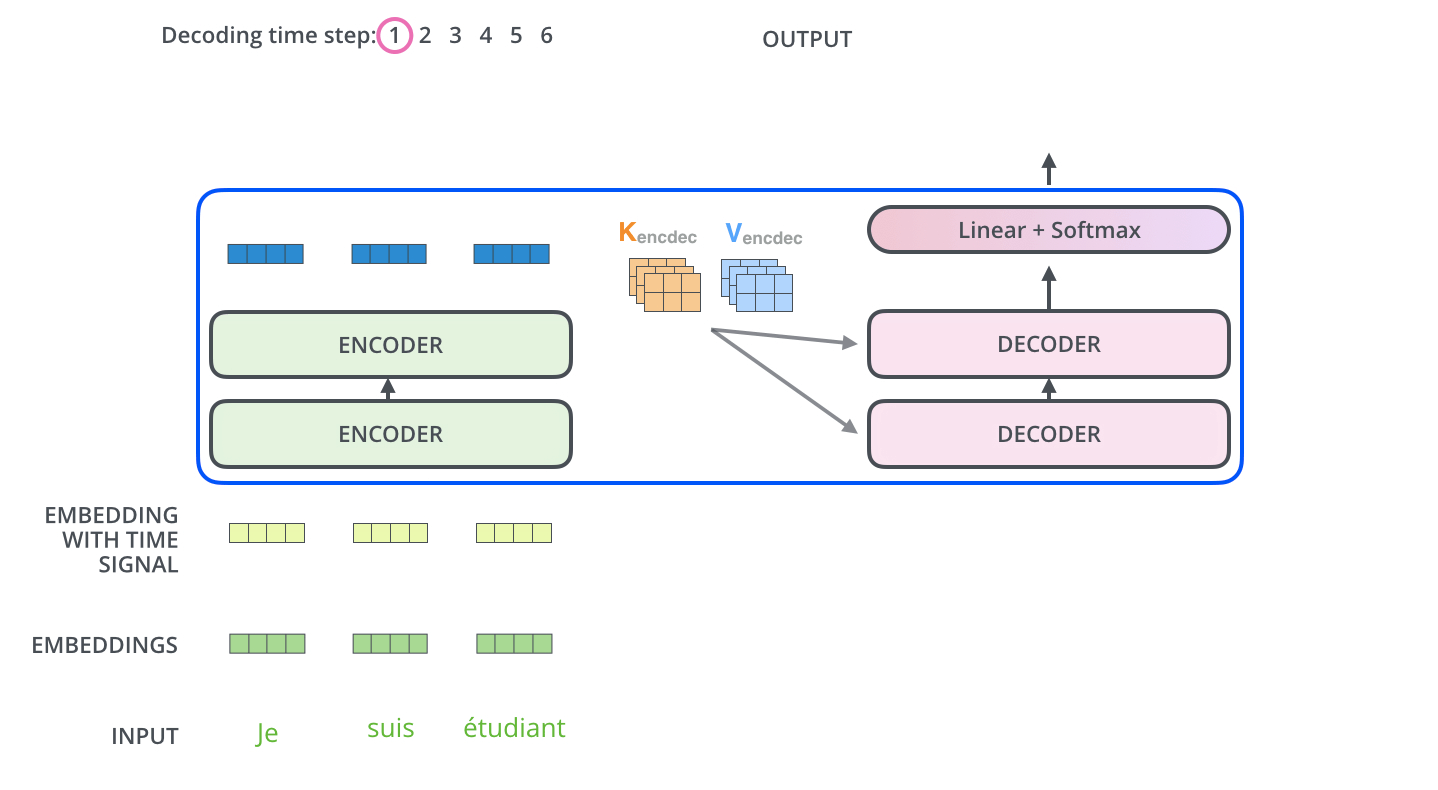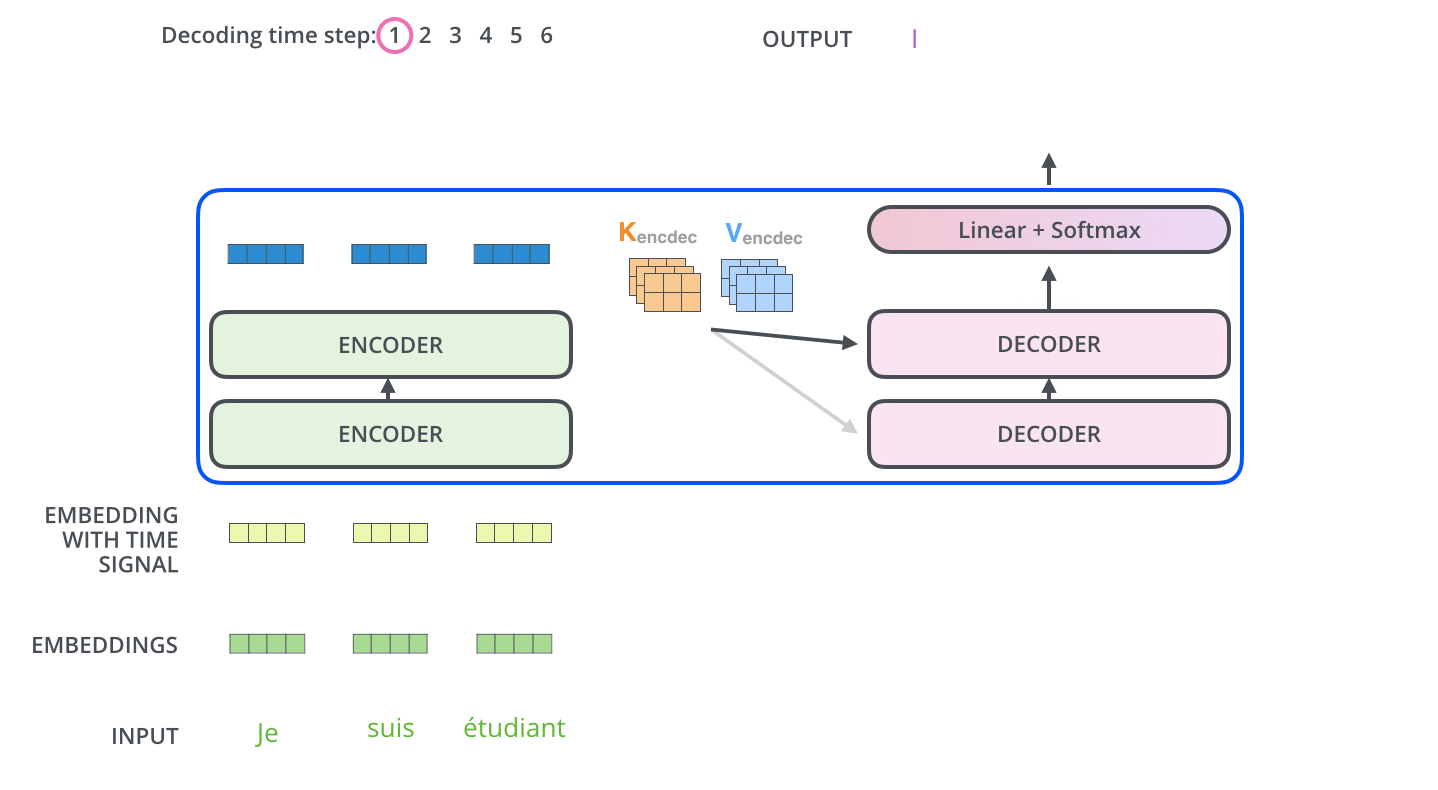
Causal mask 는 학습 때 정답 문장 전체를 한꺼번에 넣으면서도 위치 가 미래 토큰 를 못 보게 막는 장치다. softmax 이전에 미래 위치의 score 를 로 덮으면
그 자리의 softmax 가중치가 0이 된다. 덕분에 길이 문장의 모든 위치에 대한 loss 를 한 번의 forward 로 병렬 계산하면서도, 각 위치는 자기 자신과 왼쪽만 본 셈이 된다(teacher forcing). 이 causal mask 가 decoder-only LLM 의 핵심이며 다음 노트의 출발점이다.
3-3. FFN
attention sub-layer 다음에는 각 위치에 독립적으로 똑같이 적용되는 2층 MLP(multi-layer perceptron) 가 온다:
base 모델은 로 의 4배다. 차원을 한 번 넓혔다가 (ReLU(rectified linear unit) 비선형) 다시 좁힌다.
역할 분담이 분명하다: attention 은 위치 사이에서 정보를 섞고(mixing across positions), FFN 은 그 위치 안에서 정보를 변환한다(processing per position). attention 만 쌓으면 각 토큰 벡터에 대한 비선형 변환 능력이 부족하다 — FFN 이 그걸 채운다. FFN은 파라미터와 연산량의 큰 부분을 차지하며, 비중은 모델 구조에 따라 달라진다.
3-4. Residual과 정규화
각 sub-layer에 잔차 연결(residual connection)과 정규화(normalization)를 적용한다.
Residual connection.11 sub-layer 의 출력을 그 입력에 더한다: . 덕분에 backward pass 에서 gradient 가 덧셈 경로를 따라 아래층으로 전달될 직접 경로가 생긴다. 전체 gradient가 소실·폭발하지 않는다는 보장은 아니지만, 깊은 모델의 학습을 돕는다. , 나중엔 수십~수백 층을 쌓을 수 있는 것은 이 지름길 덕이다. 모양이 블록을 지나도 로 보존되기에(§1-2) 이 덧셈이 성립한다.
Layer normalization.12 각 토큰 벡터를 그 개 성분에 대해 평균을 빼고 표준편차로 나눈 뒤(수치 안정을 위한 작은 상수 포함) 학습되는 로 다시 스케일·시프트한다. batch normalization 과 달리 batch 축이나 시퀀스 축을 건드리지 않으므로 batch 크기·문장 길이에 무관하고, 순차적 의존도 없다.
덧셈과 정규화의 순서. 원논문은 sub-layer 출력을 입력에 더한 뒤에 LayerNorm 을 건다:
이 배치를 post-LN 이라 부른다.
4. 전체 조립
encoder 블록 하나(원논문의 post-LN 표기)를 차원과 함께 따라가 보자. 입력 :
MultiHead(X): head 8개가 각자 → concat → →- 첫 residual + LayerNorm 후 :
FFN(A):- 출력 : — 입력과 같은 모양
이 블록을 번 쌓으면 encoder 스택이다. decoder 블록은 두 residual 사이에 encoder–decoder attention(+ residual)을 하나 더 끼운다. decoder 스택의 마지막 출력은 vocabulary 크기의 linear + softmax 로 다음 토큰 분포가 된다. 원논문은 이 출력 projection 행렬의 가중치를 임베딩과 공유한다(weight tying).
Transformer 의 배경과 이후 전개를 되짚는 강연이 있다 — Stanford CS25 Transformers United 시리즈 (녹화 목록).
다음 노트에서는 이 구조를 encoder 계열(BERT)과 decoder 계열(GPT) 로 갈라 보고, 범용 생성 모델에서 decoder-only가 널리 쓰이는 이유를 살펴본다.
Footnotes
-
Lin, T., Wang, Y., Liu, X., & Qiu, X. (2021, v2). A Survey of Transformers. arXiv:2106.04554v2. ↩
-
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention Is All You Need. NeurIPS 2017. arXiv:1706.03762. ↩ ↩2 ↩3
-
Alammar, J. (2018). The Illustrated Transformer. ↩ ↩2
-
Rush, A., et al. (2018, 2022 rev.). The Annotated Transformer. Harvard NLP. ↩
-
Weng, L. (2018). Attention? Attention!. ↩
-
Bloem, P. (2019). Transformers from Scratch. ↩
-
Sutskever, I., Vinyals, O., & Le, Q. V. (2014). Sequence to Sequence Learning with Neural Networks. NeurIPS 2014. arXiv:1409.3215. ↩
-
Bahdanau, D., Cho, K., & Bengio, Y. (2015). Neural Machine Translation by Jointly Learning to Align and Translate. ICLR 2015. arXiv:1409.0473. ↩
-
Alammar, J. (2018). Visualizing A Neural Machine Translation Model (Mechanics of Seq2seq Models with Attention). ↩
-
Jung, H. S. (정상근, 충남대). (2024). Transformer의 큰 그림 이해 — 기술적 복잡함 없이 핵심 아이디어 파악하기. Medium. ↩
-
He, K., Zhang, X., Ren, S., & Sun, J. (2016). Deep Residual Learning for Image Recognition. CVPR 2016. arXiv:1512.03385. ↩
-
Ba, J. L., Kiros, J. R., & Hinton, G. E. (2016). Layer Normalization. arXiv:1607.06450. ↩
-
Xiong, R., et al. (2020). On Layer Normalization in the Transformer Architecture. ICML 2020. arXiv:2002.04745. ↩